
 Magazine LLM Opensource · 15 October 2026
MeMo (MIT CSAIL) : remplacer son LLM en production sans réentraînement — ce que vaut vraiment la promesse des 26 %
Changer de modèle de langage en production sans réentraînement, avec un gain de performance annoncé de 26 % : la promesse de MeMo, signée MIT CSAIL, fait l’effet d’un petit séisme dans le monde du déploiement LLM. Mais derrière le battage médiatique, que vaut vraiment cette technique de substitution modulaire ? Plongée dans une approche qui pourrait redéfinir nos pipelines d’inférence — à l’heure où l’automne 2026 voit déferler Mistral Large 4 « Le Chonk », Reflection Beam et Kolibri-1, et où la question du remplacement de modèle en production n’a jamais été aussi brûlante.
Le coup de tonnerre du MIT : remplacer son LLM sans tout réapprendre
Depuis l’explosion des modèles open source — LLaMA, Qwen, DeepSeek, Mistral — les équipes MLOps sont confrontées à un dilemme récurrent : comment intégrer un modèle plus performant sans tout casser ? Le fine-tuning complet d’un LLM coûte cher en temps et en calcul, et le retraining d’un pipeline entier pour passer de Qwen à DeepSeek peut immobiliser une infrastructure pendant des jours. Ajoutez à cela la nécessité de tester plusieurs versions en parallèle (A/B testing), d’adapter rapidement un modèle à un nouveau domaine (juridique, médical) ou de corriger des biais, et vous obtenez une équation où la rigidité des approches classiques devient un frein majeur.
Cette pression n’a fait que s’intensifier au cours de l’année 2026. Le rythme des sorties open-weight s’est accéléré de façon spectaculaire : DeepSeek V4-Pro et V4-Flash le 24 avril 2026 (1,6 billion de paramètres, 49 milliards actifs), Gemma 4 12B le 3 juin 2026, Solar Open 2 d’Upstage le 23 juillet 2026 (250B de paramètres, 15B activés), Qwen3.8-Max d’Alibaba le 3 août 2026 (2,4 billions de paramètres), Muse Glimmer le 11 août 2026, GLM-5.3 le 14 août 2026, puis un automne particulièrement dense : Kolibri-1 d’Aleph Alpha le 3 octobre 2026 (78,1 milliards de paramètres, licence Apache 2.0), Reflection Beam le 5 octobre 2026 (501B de paramètres, 23B actifs), et Mistral Large 4 — surnommé « Le Chonk » — dévoilé le 6 octobre 2026 (plus de 1 000 milliards de paramètres, 49 milliards activés par réponse, poids annoncés pour le 27 octobre). Chaque nouvelle sortie repose la même question : comment migrer sans repartir de zéro ?
C’est dans ce contexte que des chercheurs du MIT CSAIL, en collaboration avec la National University of Singapore (NUS), l’A*STAR et le Singapore-MIT Alliance for Research and Technology (SMART), ont dévoilé MeMo (Memory as a Model) — une technique qui promet de remplacer un LLM par un autre sans retraining, avec une amélioration de performance de l’ordre de 26 %. L’annonce, relayée par VentureBeat, SaaSSentinel et MarkTechPost fin mai 2026, a immédiatement suscité un vif intérêt dans la communauté. Le papier, disponible sur arXiv (référence 2605.15156, soumis le 14 mai 2026 et révisé le 20 mai 2026 en v2), détaille un mécanisme de substitution modulaire qui sépare la connaissance du raisonnement — une idée aussi élégante que radicale.
Mais attention : le papier est encore un préprint non révisé par les pairs, et aucune implémentation publique (GitHub, démo) n’a été mise à disposition à ce jour. Le battage médiatique ne doit pas faire oublier la prudence. Plongeons dans les rouages de MeMo pour comprendre ce qui se cache derrière le chiffre de 26 %.
MeMo en pratique : comment ça marche vraiment ?
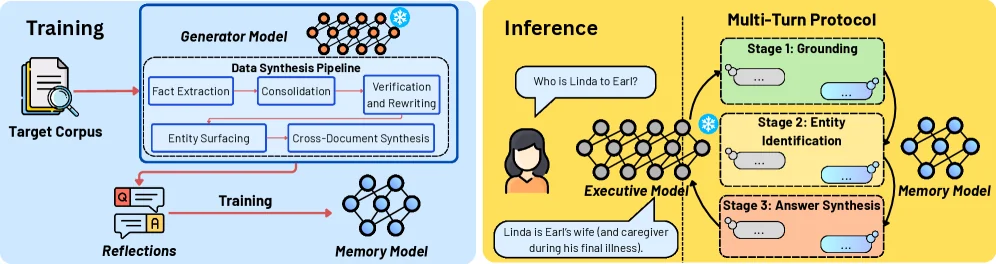
Le cœur de MeMo repose sur une séparation nette entre deux composants : un modèle de mémoire (Memory model) et un modèle exécutif (Executive model). L’idée est de ne plus considérer le LLM comme un unique bloc monolithique, mais comme un système où la connaissance factuelle est externalisée dans un petit modèle spécialisé, tandis que le modèle principal se concentre sur le raisonnement et la génération.
Concrètement, le modèle de mémoire est fine-tuné sur des paires question-réponse distillées à partir d’un corpus de connaissances. Ces paires, appelées reflections, sont générées par un modèle générateur (Generator) qui transforme des documents bruts en milliers de Q&A concis et spécifiques au domaine. Le modèle de mémoire apprend ainsi à répondre à des requêtes factuelles sans jamais avoir à lire le texte original lors de l’inférence. Le modèle exécutif (n’importe quel LLM de pointe, ouvert ou propriétaire) interroge le modèle de mémoire en langage naturel, comme s’il envoyait une requête à une API, sans nécessiter de configuration supplémentaire. Le swap de modèle se fait alors en remplaçant uniquement le modèle exécutif, sans toucher à la mémoire — qui a déjà été entraînée une fois pour toutes.
Le protocole multi-tour décrit dans le papier utilise des requêtes en langage naturel pour assurer la compatibilité entre les représentations internes du modèle de mémoire et celles du nouveau modèle exécutif. En pratique, le remplacement d’un LLM par un autre se résume à charger un nouveau checkpoint et à pointer le modèle exécutif vers le même modèle de mémoire — un processus qui peut être réalisé à chaud, sans interruption du service.
Les détails techniques fournis par MarkTechPost précisent que, dans les expériences, le modèle de mémoire est Qwen2.5-14B-Instruct, tandis que le modèle exécutif est soit Qwen2.5-32B-Instruct, soit Gemini-3-Flash, un modèle propriétaire fermé. Cette configuration illustre un point crucial : MeMo traite le modèle exécutif comme une boîte noire — il ne nécessite ni accès aux poids ni aux logits de sortie, ce qui le rend compatible avec les LLM propriétaires comme avec les modèles ouverts.
La génération des données d’entraînement suit un pipeline de synthèse en cinq étapes, guidé par un modèle générateur (Qwen2.5-32B-Instruct dans les expériences) :
- Extraction de faits – extraction directe des faits explicitement énoncés et indirecte des informations inférées, en parallèle par chunk de document.
- Consolidation – regroupement des paires Q&A partageant un contexte commun (entité, période, relations).
- (Les étapes suivantes ne sont pas détaillées dans les extraits disponibles, mais le résultat final est un jeu de données de réflexions couvrant le corpus sous diverses variations de requêtes.)
Les tests ont été menés sur plusieurs configurations, notamment avec Qwen, DeepSeek R1 et Google Gemini 3 Flash comme modèles exécutifs, et sur des benchmarks de question-réponse complexes comme NarrativeQA, MuSiQue et BrowseComp-Plus (ce dernier étant explicitement mentionné dans l’abstract arXiv). Les résultats, rapportés par SaaSSentinel, indiquent une amélioration de 26,73 % sur NarrativeQA et de 11,90 % sur MuSiQue après le swap — des gains significatifs, surtout si l’on considère qu’aucun retraining du modèle principal n’a été effectué. ScienceActu mentionne quant à lui un gain de 26,85 % sur NarrativeQA (valeur tronquée), ce qui suggère une légère variation selon les configurations ou les runs.
Mais ces chiffres doivent être pris avec précaution : ils proviennent d’articles de presse, pas du papier original lui-même (dont le texte intégral n’est pas accessible dans les extraits fournis). La métrique exacte (accuracy, F1, perplexité ?) n’est pas clairement précisée, même si le contexte de NarrativeQA (question-réponse sur récits) laisse penser à une mesure de précision des réponses.
26 % de gain : mythe ou réalité ?
Le chiffre de 26 % est devenu l’accroche marketing de MeMo. Mais que recouvre-t-il exactement ? D’après les sources disponibles, les gains mesurés sont les suivants :
| Benchmark | Gain MeMo (source SaaSSentinel) | Gain MeMo (source ScienceActu) | Robustesse au bruit (MeMo vs HippoRAG) |
|---|---|---|---|
| NarrativeQA | 26,73 % | 26,85 % (tronqué) | +0,55 % (MeMo) vs -6,22 % (HippoRAG) |
| MuSiQue | 11,90 % | Non précisé | Non précisé |
| BrowseComp-Plus | Non précisé | Non précisé | Non précisé |
Ces résultats sont impressionnants, mais plusieurs points méritent d’être soulignés. D’abord, l’absence de réplication indépendante : aucun chercheur extérieur n’a encore reproduit ces expériences. Ensuite, le gain de 26 % est une amélioration relative par rapport à quoi ? Probablement par rapport au modèle source avant swap, mais le papier n’est pas accessible pour vérifier. Enfin, la robustesse au bruit — MeMo ne perd que 0,55 % de performance quand on ajoute du bruit aux entrées, contre une chute de 6,22 % pour HippoRAG — est un indicateur intéressant, mais il provient d’une unique source (SaaSSentinel) et n’a pas été confirmé.
Il faut aussi noter que les benchmarks utilisés (NarrativeQA, MuSiQue, BrowseComp-Plus) sont des tâches de question-réponse basées sur des récits ou des documents, où la mémoire factuelle joue un rôle crucial. MeMo pourrait être moins performant sur des tâches de raisonnement pur (mathématiques, logique) où la séparation mémoire/raisonnement est moins pertinente. En l’absence de résultats sur MMLU, HellaSwag ou GSM8K, il est difficile de généraliser.
Un autre point mérite d’être souligné : l’abstract arXiv lui-même reste prudent. Il revendique cinq avantages — capture des relations inter-documents complexes, robustesse au bruit de récupération, absence d’oubli catastrophique dans le LLM, non-nécessité d’accéder aux poids ou logits, et coût de récupération indépendant de la taille du corpus à l’inférence — mais il se contente de conclure que MeMo « obtient de bonnes performances comparées aux méthodes existantes sur trois benchmarks ». Aucun chiffre absolu n’est avancé dans l’abstract : le fameux « 26 % » est une construction médiatique, pas une revendication formelle du papier. C’est une nuance importante pour quiconque envisage d’évaluer sérieusement la technique.
En attendant une validation par les pairs et des tests indépendants, le 26 % reste une promesse non encore tenue — mais suffisamment solide pour mériter une analyse approfondie.
LoRA, adaptateurs, distillation : MeMo fait-il mieux ?
MeMo n’est pas la première technique à tenter de découpler connaissance et raisonnement. Comparons-la aux approches existantes, en intégrant les évolutions récentes de l’écosystème (Unsloth, LM Studio Bionic) :
| Critère | LoRA | AdapterFusion | Distillation | MeMo | Unsloth (Faster MoE) |
|---|---|---|---|---|---|
| Modification des poids du LLM principal | Oui (matrices de bas rang) | Oui (modules spécialisés) | Non (entraîne un modèle élève) | Non | Oui (optimisation mémoire) |
| Swap à chaud sans retraining | Non (nécessite fusion des poids) | Non (nécessite réentraînement des adaptateurs) | Oui (modèle élève indépendant) | Oui | Non (fine-tuning uniquement) |
| Coût de fine-tuning | Faible (quelques % des paramètres) | Moyen (plusieurs adaptateurs) | Élevé (entraînement complet de l’élève) | Faible (fine-tuning du modèle de mémoire uniquement) | Très faible (quantification dynamique) |
| Compatibilité entre architectures | Limitée (même famille de transformeurs) | Limitée (même backbone) | Totale (modèle élève indépendant) | Partielle (requêtes en langage naturel) | Limitée (modèles supportés) |
| Surcoût mémoire à l’inférence | Négligeable | Faible (plusieurs adaptateurs) | Nul (modèle élève seul) | Significatif (modèle de mémoire en plus) | Négligeable (quantification) |
LoRA (Low-Rank Adaptation) permet de fine-tuner un LLM en n’ajoutant que quelques matrices de bas rang, mais le modèle résultant reste spécifique à la tâche et ne peut pas être échangé sans réentraînement. AdapterFusion va plus loin en combinant plusieurs adaptateurs spécialisés, mais le swap nécessite de réentraîner la fusion. La distillation produit un modèle élève plus petit et indépendant, mais le coût d’entraînement est élevé et la perte de qualité parfois importante. Unsloth, avec son module Faster MoE et Dynamic 2.0 GGUFs, permet un fine-tuning local sur GPU grand public (RTX 4090) avec une consommation mémoire réduite, mais ne résout pas le problème du swap à chaud.
L’avantage clé de MeMo est le swap à chaud : on peut remplacer le modèle exécutif sans toucher à la mémoire, ce qui ouvre des possibilités inédites en production. L’inconvénient principal est le surcoût mémoire : il faut maintenir en mémoire le modèle de mémoire (même petit) en plus du LLM principal. Ce surcoût, non chiffré dans les sources, pourrait être rédhibitoire pour des déploiements sur GPU avec mémoire limitée. De plus, la compatibilité entre architectures n’est pas garantie : les requêtes en langage naturel sont universelles, mais l’efficacité peut varier selon la capacité du modèle exécutif à formuler des questions précises.
Il faut également replacer MeMo dans le contexte plus large du RAG (Retrieval-Augmented Generation), qu’il concurrence directement. Là où le RAG classique récupère des passages de documents à chaque requête, MeMo « pré-cuit » la connaissance dans un modèle de mémoire. L’abstract revendique précisément que le coût de récupération est indépendant de la taille du corpus à l’inférence — un argument de poids face aux pipelines RAG dont la latence explose avec la croissance de l’index. Mais cette indépendance a un prix : la connaissance est figée au moment de l’entraînement du modèle de mémoire, là où un index RAG peut être mis à jour en quelques secondes. Pour des domaines à évolution rapide (veille réglementaire, actualité), le RAG garde un avantage structurel.
Qui peut en profiter ? Cas d’usage concrets dans l’écosystème 2026
MeMo n’est pas une solution universelle, mais certains scénarios d’entreprise pourraient en tirer un bénéfice immédiat.
Le premier cas d’usage est la migration de modèle en production. Imaginons une entreprise qui a déployé un assistant interne sur Qwen3.5 et qui souhaite passer à Qwen3.8-Max (2,4 billions de paramètres, dévoilé le 3 août 2026) ou à Mistral Large 4 pour ses capacités agentiques et multimodales. Avec MeMo, la connaissance métier accumulée dans le modèle de mémoire reste intacte : seul le modèle exécutif change. C’est exactement le scénario que décrivent VentureBeat et SaaSSentinel — et c’est ce qui explique l’engouement.
Le deuxième cas d’usage est l’architecture hybride ouvert/fermé. MeMo ne nécessite ni les poids ni les logits du modèle exécutif. Une entreprise peut donc conserver sa mémoire propriétaire en interne (modèle ouvert auto-hébergé) tout en exploitant un modèle de frontière fermé pour le raisonnement — ou l’inverse. Cette flexibilité est précieuse dans un contexte où, comme le note ZDNET à propos de Mistral Large 4, les modèles ouverts cherchent à devenir « la solution de défense de monsieur Tout-le-monde » face à la prolifération des agents autonomes.
Le troisième cas d’usage est la souveraineté. Avec Kolibri-1 (78,1 milliards de paramètres, Apache 2.0, publié le 3 octobre 2026) et Mistral Large 4 (entièrement entraîné en Europe, poids annoncés pour le 27 octobre), les organisations européennes disposent enfin d’alternatives crédibles aux modèles chinois et américains. MeMo permettrait de basculer d’un exécutif à l’autre selon les contraintes réglementaires, sans reconstruire la couche de connaissance — un argument qui pourrait séduire les secteurs régulés (santé, défense, finance).
Le quatrième cas d’usage est le fine-tuning spécialisé à moindre coût. Plutôt que de fine-tuner un LLM de 500 milliards de paramètres sur un corpus juridique, on entraîne un petit modèle de mémoire sur les « reflections » extraites du corpus, et on branche n’importe quel exécutif dessus. Le coût de calcul se concentre sur le petit modèle, pas sur le géant.
Cependant, ces scénarios restent théoriques tant qu’aucune implémentation n’est disponible. Et la concurrence ne dort pas : Reflection AI, avec Beam (501B de paramètres, 23B actifs, dévoilé le 5 octobre 2026), mise sur des « usines IA » permettant aux institutions de construire leurs propres systèmes locaux — une approche qui recoupe partiellement la promesse de MeMo, mais avec des modèles complets plutôt qu’une architecture mémoire/exécutif.
Les limites que le battage médiatique occulte
Il serait malhonnête de conclure sans lister les angles morts. Premièrement, l’absence de code. Aucun dépôt GitHub, aucune démo, aucun checkpoint publié. Dans un écosystème open source où Kolibri-1, Beam et Mistral Large 4 annoncent tous des poids sur Hugging Face, l’absence d’artefacts reproductibles est un signal fort : MeMo reste, à ce jour, une contribution académique.
Deuxièmement, la question de la fraîcheur de la connaissance. Le modèle de mémoire est entraîné une fois sur un corpus figé. Que se passe-t-il quand le corpus évolue ? Faut-il réentraîner la mémoire — et à quelle fréquence ? Le papier ne répond pas clairement dans les extraits disponibles. C’est précisément le point faible face au RAG, dont la mise à jour est triviale.
Troisième limite : le coût de génération des données. Le pipeline de synthèse en cinq étapes fait appel à un modèle générateur (Qwen2.5-32B-Instruct) pour produire des milliers de paires Q&A par chunk de document. Sur un corpus volumineux, ce coût de génération peut devenir significatif — et il n’est pas chiffré dans les sources.
Quatrième limite : la généralisation. Les trois benchmarks revendiqués (BrowseComp-Plus, NarrativeQA, MuSiQue) sont des tâches de QA documentaire. Aucun résultat sur le raisonnement mathématique, le code ou les tâches agentiques — précisément les domaines où les modèles de 2026 (Mistral Large 4, Beam, Solar Open 2) concentrent leurs efforts. Or c’est là que se joue la bataille commerciale.
Cinquième limite : la validation par les pairs. Le préprint a été révisé une fois (v2, 20 mai 2026) mais n’a pas encore été accepté dans une conférence. Les chiffres de 26 % proviennent d’articles de presse, pas du papier lui-même.
Verdict : une idée prometteuse, une preuve encore manquante
MeMo pose une question architecturale pertinente : et si la connaissance n’avait pas besoin de vivre dans les poids du modèle de raisonnement ? Cette séparation mémoire/exécutif rappelle les architectures cognitives classiques, et le fait qu’elle fonctionne avec des modèles propriétaires en boîte noire est indéniablement élégant.
Mais en octobre 2026, force est de constater que la promesse reste suspendue. Pas de code, pas de réplication, pas de résultats sur les benchmarks qui comptent vraiment pour l’industrie (raisonnement, code, agents). Le « 26 % » est un chiffre de presse, pas une mesure validée. Et pendant que la communauté attend, l’écosystème open source avance à une vitesse vertigineuse : Mistral Large 4 et ses 1 000 milliards de paramètres, Beam et ses 501B, Kolibri-1 et sa licence Apache 2.0 — autant de modèles qui, eux, sont réellement disponibles.
Pour les praticiens, la recommandation est simple : suivez MeMo de près, mais ne réorganisez pas votre pipeline de production sur la base d’un préprint non implémenté. En revanche, l’idée de découpler mémoire et raisonnement mérite d’être explorée — ne serait-ce que pour comprendre pourquoi les pipelines RAG actuels peinent à suivre la croissance des corpus. Si une implémentation open source voit le jour, MeMo pourrait devenir une brique incontournable. En attendant, c’est une belle idée en quête de preuves.
Sources
- MeMo: Memory as a Model — arXiv (2605.15156, v1 14 mai 2026, v2 20 mai 2026)
- MIT’s MeMo lets teams swap in a better LLM without retraining — VentureBeat
- MIT’s MeMo framework boosts LLM performance 26% without retraining — SaaSSentinel
- MeMo: A Modular Framework for Training a Dedicated Memory Model — MarkTechPost
- MeMo permet aux équipes de changer de LLM sans réentraînement — Le Fil IA
- Mistral dévoile Large 4, un modèle à plus de 1 000 milliards de paramètres — Le Monde Informatique (7 octobre 2026)
- Mistral Large 4, le modèle à 1 000 milliards de paramètres surnommé Le Chonk — Korben (7 octobre 2026)
- Mistral’s New ‘Le Chonk’ AI Model Is Big, Open and Built for Agents — CNET (7 octobre 2026)
- Sortie de Mistral Large 4 : aperçu API et poids — NeoTeo (7 octobre 2026)
- Mistral Says Its New AI Model ‘Le Chonk’ Is the Best Open-Weight Offering Outside of China — Wired (6 octobre 2026)
- Reflection AI debuts open-source Beam model with 501B parameters — SiliconANGLE (6 octobre 2026)
- Reflection debuts Beam, an open-weight AI model to rival Chinese models at lower compute cost — TechCrunch (5 octobre 2026)
- Reflection AI Unveils Beam, a 501B-Parameter Open-Weight Model — Unite.AI (5 octobre 2026)
- Kolibri-1 от Aleph Alpha: Европа возвращается в open weights — ai-stat.ru (5 octobre 2026)
- Cloudflare Clef: открытый ответ Jev в 13 раз быстрее — ai-stat.ru (3 octobre 2026)
- Clef-Flash vs Qwen3-8B : Probabilités vs prose — orcarouter.ai (2 octobre 2026)
Article recherché et rédigé automatiquement · Magazine Electrosens