
 NVIDIA DGX Spark · 6 November 2026
LLM open source sur DGX Spark : clusters 2× GB10, DeepSeek V4 Flash, fine-tuning et mises à jour d’octobre 2026 — le guide vérifié
Depuis l’annonce du DGX Spark au GTC 2025, l’idée de coupler deux de ces mini-supercalculateurs pour faire tourner localement des LLM de plusieurs centaines de milliards de paramètres fait rêver les passionnés d’IA. Un an et demi plus tard, la promesse est tenue, et même amplifiée : un cluster de deux Spark fait tourner DeepSeek V4 Flash-0731 (284B, 13B actifs) à 30-40 token/s, des modèles comme Laguna S 2.1 (118B) ou Ant Ling-3.0-Flash (124B-A5B) tiennent sur une seule machine, et Qwen3.8-27B atteint 34-38 tok/s. Mais l’automne 2026 apporte aussi son lot de mauvaises nouvelles : la crise de la RAM a fait bondir le prix du modèle 128 Go à 6 950 $, NVIDIA lance une déclinaison 64 Go à 4 999 $, et les benchmarks indépendants d’agents locaux rebattent les cartes. Plongeons dans les entrailles de cette configuration pour en démêler le vrai du faux, en nous appuyant sur les retours d’expérience de production, les mises à jour logicielles d’octobre 2026 et les tests indépendants les plus récents.
Le rêve du LLM local à deux têtes
Quand NVIDIA a dévoilé le Project DIGITS en mars 2025, rebaptisé depuis DGX Spark, l’enthousiasme a été immédiat. Ce petit boîtier de 150×150×50,5 mm – à peine plus grand qu’un Mac Mini – embarque un superchip Grace-Blackwell (GB10), 128 Go de mémoire unifiée LPDDR5x, et promet jusqu’à 1 pétaflop en calcul FP4. Commercialisé le 15 octobre 2025, le DGX Spark a immédiatement connu des ruptures de stock, confirmant l’appétit pour une station de travail IA locale.
Mais très vite, une idée a germé dans la communauté : et si on en mettait deux en cluster ? Avec 256 Go de mémoire unifiée cumulée, on pourrait théoriquement charger des modèles de plusieurs centaines de milliards de paramètres avec une quantification agressive. Les forums r/LocalLLaMA et les discussions NVIDIA se sont enflammés. Le rêve d’une alternative aux H100 à 30 000 $ était né.
Un an et demi plus tard, le paysage a radicalement changé. Les modèles open source ont évolué : DeepSeek V4 Flash-0731 (284B paramètres, 13B actifs) tourne sur deux Sparks, Laguna S 2.1 (118B) et Ant Ling-3.0-Flash (124B-A5B) tiennent sur une seule machine. Le support natif de vLLM depuis juin 2026, l’arrivée de moteurs optimisés comme TensorRT-LLM et le speculative decoding DSpark ont transformé l’écosystème. Mais le contexte matériel, lui, s’est tendu : la flambée des prix de la mémoire a fait grimper le tarif du modèle 128 Go de 3 999 $ à 6 950 $ en un an, tandis que NVIDIA a dégainé une déclinaison 64 Go à 4 999 $ pour amortir le choc. Plongeons dans les entrailles de cette configuration pour en démêler le vrai du faux, en nous appuyant sur les retours d’expérience de production et les tests indépendants les plus récents.
Anatomie d’un cluster DGX Spark : ce que dit la fiche technique
Avant de parler cluster, il faut comprendre ce qui relie deux Sparks. Chaque unité intègre une carte réseau intelligente NVIDIA ConnectX-7 avec deux baies QSFP56, offrant jusqu’à 200 Gb/s de bande passante Ethernet. Attention : contrairement à ce que certains espéraient, le NVLink-C2C (900 Go/s) est une interconnexion intra-nœud entre le CPU Grace et le GPU Blackwell, pas entre deux Sparks. L’interconnexion inter-nœud repose donc exclusivement sur Ethernet haute performance.
| Spécification | DGX Spark 128 Go (Founders Edition) | DGX Spark 64 Go | Asus Ascent GX10 | AMD Ryzen AI Halo (comparaison) |
|---|---|---|---|---|
| Prix France (2025) | 3 689 € | – | 4 000 € | – |
| Prix (2026) | 6 950 $ (≈ 6 400 €, 2 oct. 2026) | 4 999 $ (23 oct. 2026) | 2 760 € | 7 299,99 $ (Micro Center, oct. 2026) |
| Stockage NVMe | 4 To | 2 To | 1 To | 2 To |
| Mémoire unifiée | 128 Go LPDDR5x (273 Go/s) | 64 Go LPDDR5x (273 Go/s) | 128 Go LPDDR5x | 192 Go LPDDR5X (256 Go/s) |
| Réseau | 2× QSFP56 (200 Gb/s via ConnectX-7) | 2× QSFP56 | idem | – |
| Consommation annoncée | 170 W (140 W en pratique) | 170 W | 170 W | 55 W nominal / 120 W boost |
| CPU | Grace (ARM, 20 cœurs) | Grace (ARM, 20 cœurs) | Grace (ARM) | 16 cœurs Zen 5 / 32 threads |
| GPU | Blackwell GB10 (6 144 cœurs CUDA) | Blackwell GB10 | Blackwell GB10 | Radeon 8060S (40 CUs RDNA 3.5) |
| NPU | – | – | – | 50 TOPS (XDNA 2) |
Note : les prix 2026 proviennent des sources les plus récentes (Frandroid pour la hausse du 2 octobre 2026 et le lancement du 64 Go, faits datés pour l’Asus et l’AMD). Le prix européen du 64 Go n’est pas encore communiqué ; à ce rythme, on devrait tourner autour de 5 000 €, et davantage chez les constructeurs qui facturent la garantie sur site. Les prix des vendeurs tiers peuvent varier de 5 800 à 6 700 € selon les disponibilités. Du côté d’AMD, le Ryzen AI Halo est passé à une configuration 192 Go à 7 299,99 $ chez Micro Center (octobre 2026), ce qui en fait, selon TechTimes, le premier desktop compact capable de charger des modèles open-weight de 300 milliards de paramètres — mais les benchmarks indépendants continuent de donner l’avantage au DGX Spark sur la vitesse.
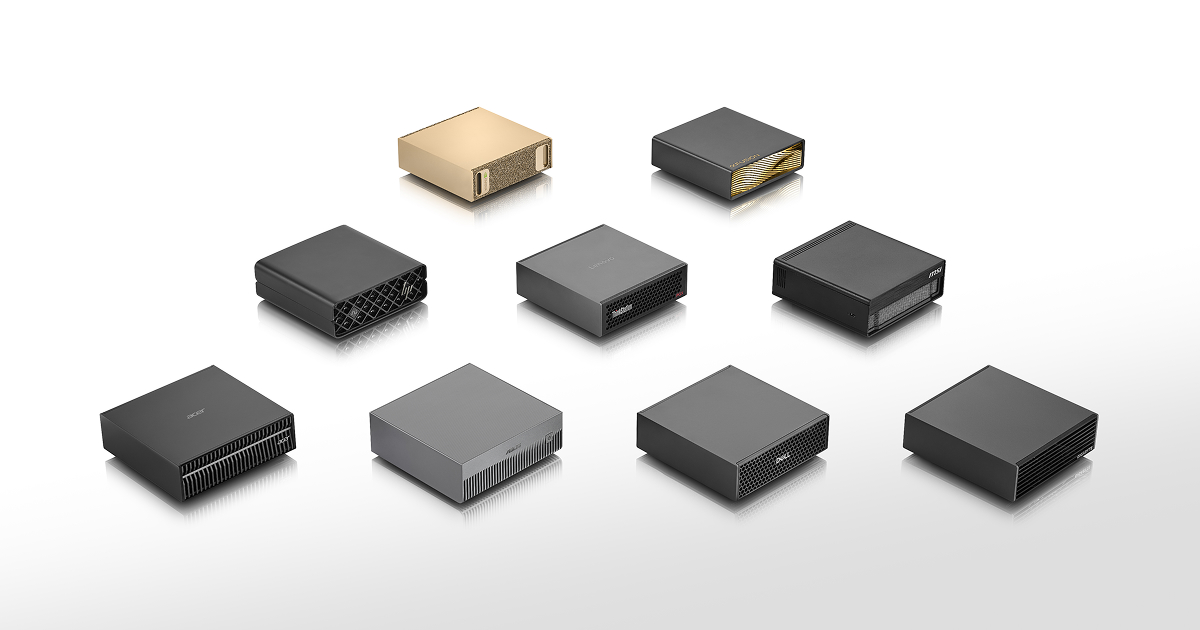
Le 64 Go n’est pas une nouvelle machine. NVIDIA le dit sans détour : c’est le même circuit imprimé, avec deux fois moins de puces mémoire. Même puce GB10 Grace Blackwell, même CPU Arm à 20 cœurs, même GPU Blackwell à 6 144 cœurs CUDA (l’équivalent d’une RTX 5070), même bande passante mémoire de 273 Go/s, même carte réseau ConnectX-7 pour relier plusieurs unités. Seuls la RAM (64 Go au lieu de 128) et le SSD (2 To visés au lieu de 4) sont rabotés. Il sera vendu à partir du 23 octobre 2026, uniquement chez Acer, Asus, Dell, Gigabyte, HP et MSI : NVIDIA ne proposera pas de Founders Edition dorée en 64 Go. ASUS a d’ailleurs officialisé dès le 5 octobre son Ascent GX10 64GB, positionné pour faire tourner « des modèles open source de 30 à 35B et des agents IA en local » avec 1 pétaflop de calcul — un positionnement volontairement plus modeste que la version 128 Go.
StorageReview, qui a publié un test pratique du cluster, identifie trois topologies possibles :
- Liaison directe 200 Gb entre les deux Sparks (le plus simple).
- Double 100 Gb en anneau sans commutateur (pour plus de redondance).
- Rôles partagés : un Spark dédié au calcul, l’autre au stockage NVMe-oF.
Le choix de la topologie impacte directement la configuration réseau. Mais dans tous les cas, la bande passante inter-nœud plafonne à 200 Gb/s, soit environ 25 Go/s – bien loin des 900 Go/s du NVLink interne. Ce goulet d’étranglement sera crucial pour les performances.
Piège du câblage : Charles Jefferies (PCMag) a découvert à ses dépens qu’il faut utiliser le port le plus à droite des deux QSFP56, et non celui de gauche, comme l’indiquent les guides officiels de NVIDIA. Une fois le câble branché, il faut configurer des comptes utilisateurs et autoriser la communication via SSH.
Mise à jour CES 2026 : lors du CES 2026, NVIDIA a annoncé une mise à jour logicielle qui multiplie par 2,5 les performances du DGX Spark et par 8 la vitesse de traitement vidéo, selon StorageReview. Cette mise à jour, déployée via la pile logicielle NVIDIA, améliore significativement l’inférence et le fine-tuning sans changement matériel.
Octobre 2026 : la mise à jour logicielle qui soude l’écosystème
Le fait le plus récent et le plus structurant pour quiconque exploite un Spark aujourd’hui est la DGX Spark Software Update d’octobre 2026, déployée à partir du 21 octobre 2026 sur les forums développeurs NVIDIA. NVIDIA précise que les systèmes partenaires équipés du même superchip GB10 Grace Blackwell reçoivent les mêmes mises à jour — bonne nouvelle pour les acheteurs d’Asus, Acer, Dell ou MSI, qui ne sont donc pas laissés pour compte sur le plan logiciel. Cette livraison d’octobre consolide la pile (drivers, CUDA, conteneurs NGC, support vLLM/TensorRT-LLM) et s’inscrit dans la continuité de la mise à jour CES 2026. C’est cette pile qu’il faut avoir en tête avant de monter un cluster : les recettes communautaires publiées plus tôt dans l’année supposent des versions de CUDA et de NCCL qu’il convient de vérifier contre cette release.
Gestion de flotte : à mesure que ces machines se déploient en entreprise, la gouvernance devient un enjeu. Le 30 juin 2026, Progress Software a annoncé que sa plateforme Progress Chef prend désormais en charge le cycle de vie et la configuration du DGX Spark, permettant aux équipes IT de provisionner, surveiller et gérer à l’échelle des flottes de ces mini-supercalculateurs. NVIDIA a cité Progress Chef comme partenaire de manageability dans son blog développeur.
La mise en œuvre : recettes MiaAI, correctifs DSpark et vision
Les premiers retours de clusteristes viennent principalement d’un fil de discussion sur les forums NVIDIA intitulé « Container-native multi-node NCCL on 2x DGX Spark – no host build required ». L’utilisateur y décrit une configuration fonctionnelle utilisant Docker avec l’image NGC nvcr.io/nvidia/pytorch:25.09-py3, CUDA 13.0 (via CUDA_HOME=/usr/local/cuda-13.0/), et NCCL 2.23. L’astuce : éviter la compilation sur l’hôte en passant par des conteneurs pré-build.
Aujourd’hui, la mise en place est simple. Les bugs initiaux (comme le port 22 bloqué sur l’interface NVLink) ont été résolus par des correctifs et une documentation claire. La procédure typique :
- Installer Docker et les drivers NVIDIA Container Toolkit.
- Tirer l’image NGC PyTorch 25.09 (ou plus récente — vérifier la release d’octobre 2026).
- Configurer les interfaces réseau (ex.
ip addr add 192.168.100.1/24 dev eth1). - Lancer les conteneurs avec
--gpus all --network hostet les variables NCCL. - Exécuter un test de communication (
nccl-tests) pour valider la bande passante.
Le verdict : c’est simple et accessible à tout utilisateur motivé. NVIDIA a publié un guide officiel pour le clustering multi-Spark, et la communauté a affiné les procédures.
La recette MiaAI : le gold standard de DeepSeek V4 Flash sur 2× DGX Spark
Le laboratoire MiaAI a publié une recette complète, désormais considérée comme la référence pour faire tourner DeepSeek V4 Flash-0731 sur deux nœuds. Elle repose sur :
- vLLM TP=2 (tensor parallelism) avec speculative decoding DSpark
- Plafond de 1M tokens de contexte
- KV cache en NVFP4 (
nvfp4_ds_mla) - Une image Docker dédiée :
ghcr.io/anemll/dspark-vllm-gx10:0.1.1
La configuration requiert deux DGX Spark avec RoCE/NCCL fonctionnels, et la même image + cache Hugging Face sur les deux nœuds. Les variables d’environnement clés sont WORKER_HOST, MASTER_ADDR, NCCL_IB_HCA, NCCL_SOCKET_IFNAME, VLLM_HOST_IP et WORKER_VLLM_HOST_IP. La recette inclut un script de préparation du cache modèle (prepare-dspark-model-cache.sh) et un script de démarrage (start-deepseek-v4-flash-dspark.sh). Les résultats sont documentés dans RESULTS-2026-08-14.md.
Poids du modèle : selon QDNA (mis à jour le 2 septembre 2026), les poids publiés de V4 Flash 0731 pèsent 167 Go (48 fichiers safetensors sur Hugging Face), et non 83,4 Go comme certaines rumeurs l’affirmaient. Le modèle est un MoE de 284 milliards de paramètres avec 13 milliards actifs par token, contexte d’un million de tokens, poids mixtes FP4 + FP8 et module DSpark fusionné.
Les correctifs DSpark : pourquoi 14-18 tok/s au lieu de 30+
Un post détaillé sur les forums NVIDIA révèle un problème critique : la recette originale est stable mais lente (14-18 tok/s en non-streaming, ~10 tok/s en streaming). La cause racine : l’héritage de la configuration de quantification du draft DSpark. Le checkpoint DeepSeek-V4-Flash-0731-NVFP4 est hybride :
- Le tronc cible utilise des experts NVFP4 ModelOpt (format ModelOpt, nécessitant
flashinfer_b12xetModelOptNvFp4FusedMoE) - Les étapes MTP/draft utilisent des experts natifs FP8/MXFP4 (poids
int8, tenseurs d’échelleUE8M0)
Sans correctif, le draft MoE est construit avec ModelOptNvFp4FusedMoE alors que ses poids ne sont pas au format ModelOpt. Les symptômes : l’acceptance du draft chute à ~1,0-1,15 tokens par étape, et le débit plafonne à 14-18 tok/s. Le patch (disponible dans recipe/apply_experiment_patches.py) consiste à retirer les clés ModelOpt du quantization_config du draft avant que son quant_config ne soit dérivé. Après application, l’acceptance remonte et le débit atteint 30 tok/s par défaut, voire plus avec des ajustements.
Ce correctif illustre un point plus large, développé dans notre dossier sur le speculative decoding sur GB10 : sur une machine à mémoire unifiée plafonnée à 273 Go/s, le gain du pari multi-token dépend entièrement de la propreté de la configuration du draft. Un draft mal quantifié ne se contente pas de « rater » : il annule le bénéfice du speculative decoding.
La vision arrive sur DeepSeek V4 Flash
Un autre post des forums NVIDIA décrit comment ajouter la vision à DeepSeek-V4-Flash-0731 sur un cluster 2× DGX Spark, sans rebuild d’image ni sacrifice du speculative decoding. La solution repose sur :
- FlyCockpit DeepEncoderV2 : un encodeur de 865 Mo (tour gelée) + un projecteur adaptateur de 40 Mo
- Un plugin vLLM (
dsv4_vision_vllm) qui enregistre un modèle wrapperDeepseekV4VisionForCausalLM - Un simple changement dans
config.json(remplacement dearchitecturesvia des symlinks)
Après redémarrage, la vitesse atteint ~50 tps (au lieu des 55-60 habituels sans vision). Le guide complet est publié dans le dépôt communautaire associé.
Performances réelles : ce que disent les chiffres
Les chiffres canoniques, issus des tests de production et des benchmarks indépendants, dessinent une image nuancée :
| Configuration | Modèle | Débit single-stream | Débit agrégé / prefill |
|---|---|---|---|
| 1× DGX Spark (antirez ds4) | DeepSeek-V4-Flash IQ2_XXS | ~14 tok/s | prefill 410 t/s |
| 1× DGX Spark (llama.cpp GGUF) | 35B-A3B | jusqu’à 67 tok/s | – |
| 2× DGX Spark (TP=2, vLLM) | DeepSeek-V4-Flash FP8 | ~41 tok/s | ~350 tok/s @ c=32 ; prefill ~1 785 t/s |
| 2× DGX Spark (recette MiaAI + patch DSpark) | DeepSeek V4 Flash-0731 | 30-40 tok/s | – |
| 1× DGX Spark | Qwen3.8-27B | 34-38 tok/s | – |
| 2× DGX Spark | taille max supportée | 405 milliards de paramètres | – |
Deux enseignements. D’abord, le cluster double bien le débit single-stream (de ~14 à ~41 tok/s sur DeepSeek V4 Flash FP8), mais surtout il débloque l’agrégation : à concurrence 32, on atteint ~350 tok/s, ce qui rend le Spark crédible pour servir plusieurs utilisateurs ou agents en parallèle. Ensuite, le plafond de 405 milliards de paramètres sur deux nœuds est la vraie limite pratique : au-delà, il faut descendre en quantification ou changer de matériel.
AA-AgentPerf-Local : le benchmark qui rebat les cartes
Le 29 septembre 2026, Artificial Analysis a publié AA-AgentPerf-Local, un benchmark dédié aux agents locaux. Au lancement, quatre matériels sont testés — DGX Spark, Ryzen AI Halo, MacBook Pro (M5 Pro) et RTX 5090 — sur quatre modèles open-weight. C’est la première évaluation indépendante qui mesure non pas le débit brut mais la performance en usage agentique (appels d’outils, boucles longues, contexte persistant). Pour les acheteurs, c’est un signal fort : le débit en tok/s ne suffit plus à juger une machine, et les résultats d’AA-AgentPerf-Local doivent désormais être consultés avant tout achat.
Nemotron 3.5 Lightning : le cheval de bataille officiel
NVIDIA a fait de Nemotron-3.5 Lightning son modèle de référence pour les agents longue durée sur DGX Spark. Le 30 octobre 2026, la firme a détaillé sur blockchain.news un workflow en ligne de commande pour faire tourner Nemotron-3.5 Lightning sur le DGX Spark 64 Go, avec benchmarks et résultats de speculative decoding à l’appui. C’est un point important : la version 64 Go, malgré sa mémoire réduite, est officiellement ciblée pour les agents — ce qui confirme le positionnement de la déclinaison économique.
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
Le fine-tuning local est l’un des arguments les plus forts du Spark, et la stack 2026 le rend concret. Les mises à jour logicielles successives (CES 2026, puis octobre 2026) ont amélioré l’inférence et le fine-tuning sans changement matériel. Concrètement, sur un seul Spark 128 Go, on peut ajuster des modèles de taille moyenne (jusqu’à ~30-35B en quantification) ; sur deux nœuds, on monte vers des modèles plus gros, mais le goulet inter-nœud à 200 Gb/s limite l’efficacité du parallélisme d’entraînement par rapport à un cluster NVLink.
Les recettes communautaires (MiaAI, dépôts antirez) montrent que le fine-tuning de type LoRA sur des modèles de 7 à 30B est réaliste en local, tandis que le full fine-tuning de modèles 70B+ reste hors de portée confortable. La quantification NVFP4, désormais bien supportée par vLLM et TensorRT-LLM, est la clé pour tenir dans la mémoire unifiée.
Le cluster en pratique : topologies, pièges et gestion
Monter un cluster 2× Spark reste accessible, mais quelques pièges persistent : le port QSFP56 « de droite », la configuration NCCL/RoCE, et surtout la cohérence des versions logicielles entre les deux nœuds. La release d’octobre 2026 simplifie ce dernier point en alignant les systèmes partenaires sur la même pile que le Founders Edition.

Pour les flottes, Progress Chef (30 juin 2026) apporte le provisioning et le monitoring à l’échelle. Pour les particuliers, la topologie « liaison directe 200 Gb » reste la plus simple et la plus performante.
Conclusion : un écosystème mûr, un matériel sous tension
À l’automne 2026, le DGX Spark n’est plus une promesse : c’est une plateforme mûre, avec une pile logicielle consolidée (release d’octobre 2026), des modèles open-weight de premier plan (DeepSeek V4 Flash, Nemotron 3.5 Lightning, Qwen3.8, Laguna S 2.1, Ant Ling-3.0-Flash), des recettes de cluster éprouvées et des benchmarks indépendants (AA-AgentPerf-Local) pour juger objectivement. Mais le matériel est sous tension : la crise de la RAM a fait grimper le prix du 128 Go à 6 950 $, et le 64 Go arrive à 4 999 $ — plus cher, à sa sortie, que le 128 Go ne l’était en 2025. Le choix entre un Spark 128 Go, un 64 Go, un Ascent GX10 ou un Ryzen AI Halo 192 Go dépend désormais moins du débit brut que de la mémoire dont vous avez besoin et du type d’agents que vous voulez faire tourner.
Sources

- DGX Spark Software Updates – October 2026 Release — forums développeurs NVIDIA, 21 octobre 2026
- NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM — 30 octobre 2026
- ASUS Ascent GX10 64GB: Compact Agentic AI Supercomputer — 5 octobre 2026
- Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher — 4 octobre 2026
- DGX Spark 64 Go : NVIDIA annonce une configuration — 3 octobre 2026
- AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed — 14 octobre 2026
- Progress Software launches Progress Chef for NVIDIA DGX Spark — 30 juin 2026
- Recette MiaAI DeepSeek V4 Flash DSpark 2× DGX Spark
- DeepSeek V4 Flash 0731 DSpark 1M NVFP4 KV 2× DGX Spark — forums NVIDIA
- DeepSeek V4 Flash with Vision — forums NVIDIA
- Artificial Analysis, AA-AgentPerf-Local — 29 septembre 2026
- Nvidia RTX Spark : la puce qui a deux ans de retard — 15 octobre 2026
- NVIDIA prépare la révolution du PC portable — 15 octobre 2026
Article recherché et rédigé automatiquement · Magazine Electrosens