
 NVIDIA DGX Spark · 5 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : NVFP4, PAIR, fine-tuning et clusters — le point complet à l’automne 2026
Alors que le DGX Spark de NVIDIA promet de démocratiser le développement d’agents IA sur un poste de travail, la véritable révolution se niche dans sa capacité à s’agréger en cluster. Orchestrer plusieurs de ces mini-supercalculateurs avec Kubernetes ouvre la voie à des architectures multi-agents, du fine-tuning distribué et des services de LLM scalables, le tout sur un matériau qui tient dans un sac à dos. Avec des modèles comme DeepSeek V4.1-Flash, Laguna S 2.1 de Poolside, MiMo-V2.6 de Xiaomi et Ant Ling-3.0-Flash, l’écosystème open source n’a jamais été aussi dynamique. Et depuis le 3 septembre 2026, NVIDIA a officialisé PAIR, un outil d’orchestration qui pourrait bien redéfinir la frontière entre workstation et datacenter. Neuf mois après la commercialisation du superchip GB10 Grace Blackwell, où en est-on vraiment ? Plongée au cœur d’une infrastructure en pleine ébullition — et de ses zones d’ombre.
Le GB10 Grace Blackwell : anatomie d’un cluster en boîte
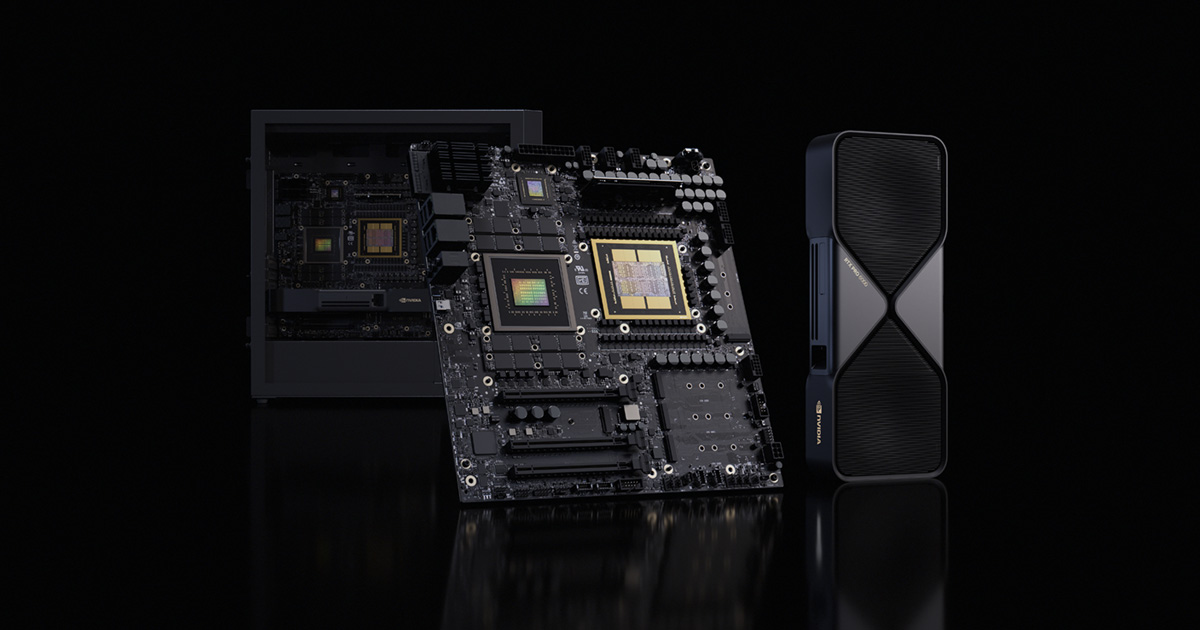
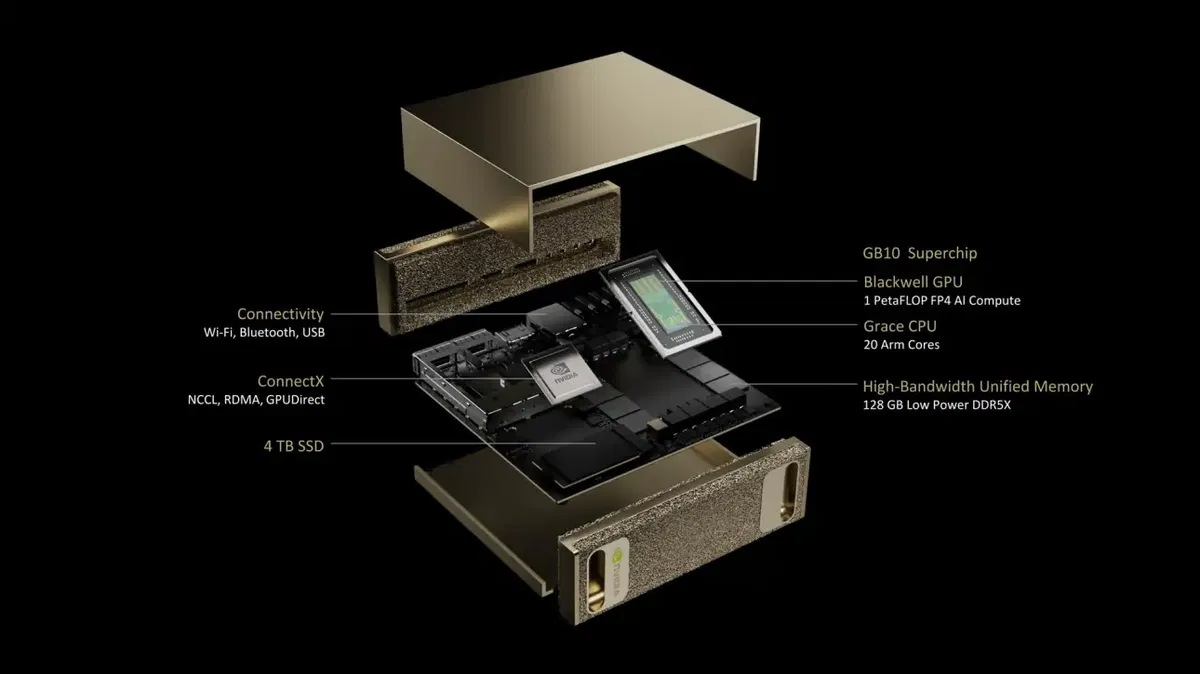
Le DGX Spark n’est pas un simple PC IA de plus. Sous son châssis compact se cache le superchip NVIDIA GB10 Grace Blackwell, une architecture qui fusionne CPU et GPU dans un espace mémoire unifié. Avec ses 20 cœurs ARM (architecture Neoverse V2, dix cœurs performance et dix cœurs efficience) et ses 128 Go de mémoire LPDDR5X partagée entre le processeur et le GPU, le Spark offre une bande passante de 273 Go/s – un chiffre qui le place bien au‑delà des stations de travail traditionnelles équipées de mémoire séparée.
Le GPU Blackwell intégré délivre 1 pétaflop en FP4 sparse, une puissance que NVIDIA compare à celle d’une RTX 5070/5070 Ti pour les charges IA. Cette équivalence n’est pas anodine : elle signifie qu’un seul Spark peut faire tourner des modèles jusqu’à 200 milliards de paramètres en local, et jusqu’à 405 milliards en couplant deux unités. Pour le fine-tuning, la limite annoncée est de 70 milliards de paramètres avec les techniques LoRA/QLoRA – et la communauté a déjà démontré qu’un full fine-tune en BF16 sur un modèle 70B est possible sans quantification, grâce aux 128 Go unifiés.
Le paysage tarifaire, lui, a sensiblement bougé. Le prix public de la version 128 Go se situait autour de 4 679 $ (hors taxes) au lancement, mais depuis le 23 octobre 2026, la donne a changé : la déclinaison 64 Go est arrivée en boutique à 4 999 $, pendant que la version 128 Go franchissait les 6 000 $ sur le marché. Une hausse directement imputable à l’envolée du cours de la mémoire (LP)DDR5. Des variantes OEM comme l’ASUS Ascent GX10 restent positionnées 500 à 1 000 $ sous le tarif NVIDIA officiel, ce qui rend l’écosystème encore plus accessible — à condition de comparer à configuration égale.
| Caractéristique | DGX Spark 128 Go | DGX Spark 64 Go | Station de travail classique (ex. RTX 4090) |
|---|---|---|---|
| CPU | 20 cœurs ARM (Grace, Neoverse V2) | 20 cœurs ARM (Grace, Neoverse V2) | x86 (Intel/AMD) |
| Mémoire unifiée | 128 Go LPDDR5X (273 Go/s) | 64 Go LPDDR5X | 24–48 Go VRAM + RAM séparée |
| Performance IA | 1 PFLOP (FP4) | 1 PFLOP (FP4) | ~0,8 PFLOP (FP8) |
| Connectivité cluster | 2× QSFP 200 Gbps + 10 GbE | 2× QSFP 200 Gbps + 10 GbE | 1× 10 GbE (souvent) |
| Consommation | 240 W max (170 W typique) | 240 W max (170 W typique) | 450 W+ |
| OS | DGX OS (Ubuntu Server 24.04 ARM) | DGX OS (Ubuntu Server 24.04 ARM) | Windows/Linux |
| Prix indicatif | > 6 000 $ (marché, oct. 2026) | 4 999 $ (depuis le 23 oct. 2026) | 2 500–4 000 $ (GPU seul) |
Ce qui rend le Spark particulièrement adapté au clustering, c’est son NVLink‑C2C – une liaison à haute vitesse qui connecte directement le CPU Grace au GPU Blackwell, permettant un accès mémoire cohérent sans copie inutile. Combiné aux deux ports QSFP ConnectX‑7 200 Gbps, chaque nœud peut communiquer avec ses voisins à une latence minimale, essentielle pour les workloads distribués comme le fine-tuning ou l’inférence multi‑GPU.
Mises à jour logicielles : de NVFP4 à la release d’octobre 2026
La cadence de NVIDIA sur le logiciel du Spark s’est accélérée au fil de l’année. La release de juillet 2026 (DGX OS 7.5.0, driver 580.159.03, CUDA 13.0.2, kernel Canonical 6.17) apportait plusieurs améliorations notables :
- Gestion mémoire améliorée : le driver inclus améliore la gestion des situations de mémoire insuffisante (OOM) avec l’architecture mémoire unifiée du GB10. L’utilisateur reçoit désormais un retour clair lorsque le système rencontre une pression mémoire, ce qui renforce la robustesse lors de l’exécution de modèles plus volumineux.
- Mémoire d’affichage ajustable : la mémoire réservée à l’affichage peut être basculée entre 2 Go (défaut) et 4 Go via le BIOS. Les workflows qui nécessitent l’affichage de nombreuses applications et fenêtres bénéficient d’une plus grande réserve ; les utilisateurs en mode appliance n’ont pas besoin de modifier les réglages par défaut.
- Cloud-init enrichi : le framework d’initialisation cloud prend désormais en charge les protocoles réseau DHCP, HTTP et TFTP en plus des connexions USB directes. La personnalisation de l’image de récupération FastOS est également supportée.
- Correction de stabilité : le problème d’instabilité système et d’affichage lors du hot-plugging d’écrans a été résolu.
La mise à jour de juin 2026 avait introduit le format de quantification propriétaire NVFP4 (NVIDIA Floating Point 4), qui promet un gain de performance de 2,6× par rapport à FP8 sur certains modèles, en particulier pour l’inférence avec des contextes longs. Couplée à l’arrivée de NemoClaw, un blueprint open source pour agents autonomes, et à un clustering simplifié à 4 nœuds, la plateforme est devenue plus polyvalente.
Mais c’est la release d’octobre 2026 qui constitue le jalon le plus récent. Publiée le 2 octobre 2026 — et déployée à partir du 21 octobre selon les forums développeurs NVIDIA —, elle embarque DGX OS 7.6.0, le noyau 7.0, le pilote 580.178.04 et CUDA 13.0.3. Sur le papier, la promesse d’un rythme de croisière maîtrisé. Dans les faits, plusieurs réserves méritent d’être posées : la procédure de rollback et l’ordre des mises à jour (firmware, noyau, pilotes) ne sont pas entièrement documentés, et la compatibilité des conteneurs NGC, de vLLM et de llama.cpp avec cette nouvelle base relève parfois de la loterie selon les versions épinglées. Un conseil d’architecte : figer vos images conteneurs avant de migrer, et tester la release sur un nœud isolé avant de propager au cluster.
Le 3 septembre 2026, NVIDIA a franchi un cap supplémentaire avec PAIR (Personal AI Router, parfois décrit comme Personal AI Runtime), un outil d’orchestration gratuit et open source conçu pour piloter l’IA locale sur les machines Spark. PAIR découvre les appareils compatibles sur le réseau domestique et route l’inférence entre eux — une manière pour NVIDIA de fédérer un « datacenter IA personnel » à partir de machines inactives. La documentation officielle, accessible sur build.nvidia.com/spark/pair, détaille d’ailleurs l’installation et l’usage de PAIR avec llama.cpp, confirmant que l’orchestrateur n’est pas verrouillé sur un moteur unique. Cette annonce s’accompagne de la gamme PC Spark, des machines pré-construites par ASUS, MSI et d’autres OEM. Selon Shattered, 8 OEM commercialisent désormais des mini-PC RTX Spark en 2026, Acer ayant livré ses premières machines dès le 8 septembre 2026.
L’écosystème logiciel s’élargit : CUDA 13.4 pour Windows Arm
Le 22 juillet 2026, NVIDIA a publié la première version préliminaire de CUDA 13.4 pour Windows sur Arm, native à Arm64. Cette annonce majeure permet aux développeurs de préparer des applications pour les futures machines RTX Spark – les versions grand public du GB10 – avec des chemins de compilation natifs et croisés. SEGA l’a déjà prise en charge, et les pilotes confirment les deux variantes du processeur N1X. Un indice concret de cette bascule : le firmware du DGX Spark déployé début septembre 2026 ajoute désormais un certificat de démarrage Windows UEFI CA, tandis que NVIDIA confirme la mise en vente des PC RTX Spark sous Windows en octobre 2026. Pour les utilisateurs de DGX Spark, cette évolution signifie que l’écosystème CUDA, déjà mature sur Linux, s’étend progressivement à Windows, élargissant encore les possibilités de déploiement local.
Réseau et stockage : les fondations d’un cluster DGX Spark
Construire un cluster de DGX Spark commence par le réseau. NVIDIA a équipé chaque Spark d’un Ethernet 10 GbE natif pour le trafic de gestion et d’administration, et de deux ports QSFP (ConnectX‑7) à 200 Gbps dédiés au trafic GPU direct. Pour un cluster de 2 à 8 nœuds, l’architecture recommandée consiste à :
- Réseau de données : utiliser les ports QSFP avec RoCE v2 (RDMA over Converged Ethernet) pour les échanges NCCL entre GPU. Un switch 200 Gbps (ou 100 Gbps en mode dégradé) suffit pour 4 nœuds.
- Réseau de gestion : le port 10 GbE natif, connecté à un switch séparé, pour l’accès SSH, Kubernetes API, et le stockage NFS.
Côté stockage partagé, plusieurs options s’offrent à l’architecte :
- NFS : la solution la plus simple, mais limitée en bande passante. Un serveur NFS sur un nœud avec NVMe local peut suffire pour des volumes de modèles et de données modérés.
- Rook/Ceph : déployé sur les NVMe locaux des Spark (chaque Spark peut accueillir un SSD M.2), il offre un stockage objet et bloc distribué, résilient et performant. Idéal pour les checkpoints de fine-tuning.
- Lustre : pour les workloads lourds (plusieurs To de données d’entraînement), un système de fichiers parallèle comme Lustre peut être monté via les ports QSFP, mais nécessite une infrastructure dédiée.
Dans un cluster de 4 Spark, une configuration éprouvée consiste à dédier un nœud au stockage Ceph (avec 2 NVMe en RAID0) et les trois autres au calcul. Le réseau de données QSFP assure que les lectures de données n’impactent pas le trafic d’inférence.
La mise à jour de juin 2026 a également simplifié la configuration multi-nœuds : NVIDIA propose désormais un guide de clustering guidé qui réduit le temps de déploiement à quelques minutes, avec des playbooks Ansible disponibles sur GitHub. Ces playbooks automatisent l’installation de Kubernetes, du GPU Operator et de NemoClaw sur l’ensemble du cluster. La communauté a également développé des outils complémentaires comme sparkrun, qui permet de lancer, gérer et arrêter des workloads d’inférence LLM sur les systèmes DGX Spark, et spark-vllm-docker pour des conteneurs Docker optimisés.
Kubernetes sur DGX Spark : installer le GPU Operator et exposer les ressources
Déployer Kubernetes sur un cluster DGX Spark peut se faire via K3s – une distribution légère certifiée CNCF, qui fonctionne avec seulement 512 Mo de RAM. Pour un cluster de production, kubeadm ou Rancher sont préférables, mais K3s simplifie l’expérimentation.
L’étape cruciale est l’installation du NVIDIA GPU Operator. Ce dernier expose automatiquement les GPUs Grace Blackwell aux pods via le device plugin Kubernetes. Il permet également de configurer :
- MIG (Multi‑Instance GPU) : partitionner le GPU en instances plus petites. Utile pour isoler des agents légers.
- Time‑Slicing : partager temporellement le GPU entre plusieurs pods sans partitionnement matériel.
- MPS (Multi‑Process Service) : optimiser l’utilisation mémoire et le débit pour les charges d’inférence concurrentes.
Un manifeste typique pour allouer un GPU à un pod d’inférence ressemble à :
apiVersion: v1
kind: Pod
metadata:
  name: llm-inference
spec:
  containers:
  - name: vllm
    image: vllm/vllm-openai:latest
    resources:
      limits:
        nvidia.com/gpu: 1
Le GPU Operator s’occupe de mapper la demande au bon profil. Pour les charges de fine-tuning, on préférera un GPU entier (sans MIG) pour maximiser la mémoire.
Attention : le device plugin NVIDIA pour Kubernetes nécessite une version récente sur le DGX Spark, car les versions antérieures plantent avec l’erreur error getting device memory: Not Supported en raison de l’architecture mémoire unifiée du GB10. Consultez la documentation officielle NVIDIA Base Command pour des instructions à jour, et vérifiez systématiquement la compatibilité du plugin avec la release DGX OS 7.6.0 d’octobre 2026.
vLLM : le moteur d’inférence de référence sur DGX Spark
Le blog officiel de vLLM (juin 2026) détaille comment le moteur d’inférence s’adapte à l’architecture du DGX Spark. Points clés :
- Mémoire unifiée : le CPU, le GPU, le système d’exploitation, le runtime conteneur, les poids du modèle et le cache KV partagent un seul pool de 128 Go (ou 64 Go). Les flags de service doivent donc laisser de la marge (
--gpu-memory-utilizationdoit être ajusté pour laisser de la place au système et au cache KV). - Batch continu et cache KV paginé : essentiels pour tirer parti de la bande passante mémoire de 273 Go/s.
- Kernels NVFP4 : vLLM intègre des kernels optimisés pour le format de quantification NVIDIA, avec des gains sensibles sur les contextes longs.
Les chiffres terrain confirment l’intérêt du tensor parallelism. Sur deux Spark en TP=2 avec vLLM et DeepSeek-V4-Flash en FP8, on mesure un débit single-stream d’environ 41 tok/s, un prefill d’environ 1 785 tok/s et un débit agrégé d’environ 350 tok/s à concurrence 32. Le pool de cache KV partagé atteint 1 105 096 tokens — de quoi servir de longues conversations d’agents sans purge intempestive. En mono-nœud avec llama.cpp, un modèle de type 35B-A3B grimpe jusqu’à 67 tok/s, tandis qu’un DeepSeek-V4-Flash en IQ2_XXS via ds4.c plafonne autour de 14 tok/s en single-stream (prefill ~410 tok/s). Tout dépend donc du moteur, du quant et du nombre de nœuds.
Les LLM open source qui tournent vraiment sur GB10
La vraie question, pour l’architecte, n’est pas « quel est le meilleur modèle » mais « quel modèle tient dans 128 Go (ou 64 Go) et à quelle vitesse ». L’écosystème open-weight de l’automne 2026 offre un éventail remarquable :

- DeepSeek V4.1-Flash (et sa déclinaison V4-Flash) : le MoE de référence, 284 milliards de paramètres totaux pour seulement 13 milliards actifs. C’est précisément ce profil « sparse » qui le rend viable sur Spark : seuls les experts activés consomment de la bande passante, ce qui compense la relative modestie des 273 Go/s face à un HBM de datacenter. En FP8 sur deux nœuds, il tourne à pleine charge ; en quantifications plus agressives (IQ2_XXS), il tient sur un seul Spark.
- Laguna S 2.1 de Poolside : le premier grand open-weight américain depuis onze mois, qui domine les modèles ouverts sur les benchmarks officiels tout en restant derrière les meilleurs propriétaires.
- MiMo-V2.6 de Xiaomi et Ant Ling-3.0-Flash : deux options asiatiques efficaces, bien adaptées aux charges d’agents.
- Nemotron-3.5 Lightning : NVIDIA a publié le 30 octobre 2026 un workflow en ligne de commande pour exécuter ce modèle sur DGX Spark 64 Go, avec données de benchmark et résultats de speculative decoding à l’appui — un signal clair que NVIDIA pousse sa propre famille sur la machine.
Pour comparer objectivement, il faut un protocole. C’est tout l’objet de Spark Arena, qui met tous les modèles à égalité sur le même matériel, et de AA-AgentPerf-Local, le benchmark publié par Artificial Analysis le 29 septembre 2026. Ce dernier teste 4 modèles open weight sur quatre plateformes au lancement : DGX Spark, Ryzen AI Halo, MacBook Pro (M5 Pro) et RTX 5090. C’est aujourd’hui la référence pour départager les machines sur des tâches d’agents réelles plutôt que sur des tokens par seconde abstraits.
Benchmarks réels : ce que crache vraiment une Spark
Les chiffres « officiels » (1 PFLOP FP4) ne disent rien de l’expérience utilisateur. Les mesures de la communauté, elles, sont plus parlantes :
| Configuration | Modèle / moteur | Débit single-stream | Débit agrégé / prefill |
|---|---|---|---|
| 1× Spark | DeepSeek-V4-Flash IQ2_XXS (ds4.c) | ~14 tok/s | prefill ~410 tok/s |
| 1× Spark | 35B-A3B (llama.cpp GGUF) | jusqu’à 67 tok/s | — |
| 2× Spark (TP=2) | DeepSeek-V4-Flash FP8 (vLLM) | ~41 tok/s | ~350 tok/s @ c=32 ; prefill ~1 785 tok/s |
La lecture est simple : un seul Spark est excellent pour un agent mono-utilisateur ou un petit service interne, mais le passage à deux nœuds change d’échelle — le débit agrégé triple presque, et le cache KV partagé dépasse le million de tokens. C’est là que le cluster prend tout son sens.
Il faut aussi situer le Spark face à la concurrence. L’AMD Ryzen AI Halo 192 Go, lancé à 7 299,99 $ chez Micro Center (mi-octobre 2026), est le premier desktop compact capable de charger des modèles open-weight de 300 milliards de paramètres. Mais les benchmarks indépendants sont nuancés : le Halo gagne sur la capacité (192 Go), le DGX Spark gagne sur la vitesse et sur la maturité de l’écosystème CUDA. Un arbitrage capacité/vitesse qui dépend entièrement de votre usage.
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
Le fine-tuning est l’argument massue du Spark face aux Mac. Avec 128 Go unifiés, on peut :
- LoRA/QLoRA jusqu’à 70 milliards de paramètres confortablement, en laissant de la marge pour le cache d’optimiseur et les activations.
- Full fine-tune BF16 sur un 70B, sans quantification, en exploitant l’intégralité de la mémoire unifiée — une prouesse impossible sur une RTX 4090 (24 Go).
- Fine-tuning distribué sur plusieurs nœuds via les playbooks Ansible et le réseau QSFP, pour les modèles qui dépassent la capacité d’un seul Spark.
La stack logicielle suit : les conteneurs NGC fournissent NeMo, PyTorch et les bibliothèques de training prêtes à l’emploi, et NemoClaw ajoute une couche d’agents autonomes. La limite pratique reste la bande passante mémoire (273 Go/s) : un full fine-tune de 70B sera plus lent que sur un HBM de datacenter, mais il fonctionnera, ce qui est déjà l’essentiel pour un laboratoire ou une PME qui ne veut pas louer de cloud.
Clusters DGX Spark : deux, quatre, huit nœuds
La vraie force du Spark, c’est de pouvoir s’empiler. Les configurations documentées vont de 2 à 8 nœuds :
- 2 nœuds : jusqu’à 405 milliards de paramètres supportés, tensor parallelism via vLLM, cache KV partagé dépassant le million de tokens. C’est le sweet spot coût/performance pour un service d’inférence sérieux.
- 4 nœuds : la configuration « cluster simplifiée » introduite en juin 2026, avec playbooks Ansible et guide de déploiement rapide. Idéale pour le fine-tuning distribué et les architectures multi-agents.
- 8 nœuds : le plafond pratique pour un déploiement sur réseau QSFP avec switch 200 Gbps, au-delà duquel la topologie réseau et le stockage partagé deviennent le goulot d’étranglement.
L’orchestration peut se faire avec Kubernetes (K3s pour l’expérimentation, kubeadm/Rancher pour la production) ou, plus simplement, avec PAIR qui route l’inférence entre les nœuds découverts sur le réseau. La documentation PAIR confirme d’ailleurs l’intégration avec llama.cpp, ce qui laisse le choix du moteur.
Un mot sur l’alternative « un gros ou deux petits » : depuis le 23 octobre 2026, un Spark 64 Go coûte 4 999 $ et un 128 Go dépasse les 6 000 $. Deux 64 Go (~10 000 $) offrent 128 Go distribués avec deux GPUs et un réseau QSFP — souvent plus intéressant pour l’inférence parallèle qu’un seul 128 Go, mais plus complexe à administrer. À chacun de trancher selon sa tolérance à la complexité.
Perspectives : un écosystème qui mûrit, des pièges à connaître
Neuf mois après le lancement, le DGX Spark n’est plus une curiosité : c’est une plateforme avec une cadence de releases trimestrielle, un écosystème logiciel dense (CUDA, vLLM, llama.cpp, NGC, PAIR, NemoClaw) et une communauté active (playbooks, sparkrun, Spark Arena). Les LLM open source de l’automne 2026 — DeepSeek V4.1-Flash en tête — tiennent leurs promesses sur cette architecture, à condition d’accepter les quantifications et de bien dimensionner le cluster.
Mais l’architecte doit garder en tête les pièges : la procédure de mise à jour d’octobre 2026 n’est pas entièrement documentée (rollback, ordre firmware/noyau/pilotes), la compatibilité des conteneurs varie selon les versions, et le prix de la mémoire a fait bondir le ticket d’entrée. Le Spark reste un excellent choix pour qui veut un datacenter IA personnel maîtrisé — à condition de figer ses images, de tester sur un nœud avant de propager, et de comparer sérieusement avec un Ryzen AI Halo 192 Go si la capacité prime sur la vitesse.
La frontière entre workstation et datacenter n’a jamais été aussi floue. Et c’est précisément là que se joue la prochaine bataille de l’IA locale.
Sources
- DGX Spark Software Updates – October 2026 Release (forums.developer.nvidia.com)
- Install and Use NVIDIA PAIR with llama.cpp | DGX Spark (build.nvidia.com)
- NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM (blockchain.news, 30 octobre 2026)
- AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed (techtimes.com, 14 octobre 2026)
- ASUS Ascent GX10 64GB: Compact Agentic AI Supercomputer (press.asus.com, 5 octobre 2026)
- Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher (generation-nt.com, 4 octobre 2026)
- NVIDIA lance un DGX Spark 64 Go (clubic.com, 2 octobre 2026)
- Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? (frandroid.com, 2 octobre 2026)
- Le DGX Spark Perd La Moitié De Sa Mémoire Mais Conserve Son Tarif De 4 999 Dollars (pausehardware.com, 2 octobre 2026)
- NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs (tech-insider.org, 8 octobre 2026)
- Playbooks DGX Spark (GitHub NVIDIA)
- sparkrun (GitHub)
- spark-vllm-docker (GitHub)
- Shattered
Article recherché et rédigé automatiquement · Magazine Electrosens