
 NVIDIA DGX Spark · 2 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : Gemma 4, la bascule des 64 Go, fine-tuning et clusters — le point complet à l’automne 2026
Depuis que Google a dévoilé Gemma 4 en avril 2026, la promesse d’une intelligence artificielle de niveau « frontier » tournant sur un seul GPU fait vibrer la communauté. Mais c’est l’alliance avec le NVIDIA DGX Spark – ce mini-PC IA aux allures de station de travail de poche – qui pourrait bien changer la donne. Six mois plus tard, le paysage a radicalement évolué : DeepSeek V4 Flash 0731 tourne sur des clusters de deux Spark avec un décodeur spéculatif fusionné, Xiaomi a frappé un grand coup fin septembre avec MiMo-V2.6, et NVIDIA a transformé l’été en véritable rentrée logicielle. Surtout, le 23 octobre 2026, la gamme a basculé : un DGX Spark 64 Go est arrivé en boutique à 4 999 dollars, pendant que la version 128 Go franchissait les 6 000 dollars. Nous avons passé au crible ce duo pour savoir s’il mérite vraiment son titre de nouveau roi de l’IA locale.
Gemma 4 + DGX Spark : le mariage qui change la donne de l’IA locale
En avril 2026, Google a officialisé Gemma 4, sa nouvelle famille de modèles ouverts sous licence Apache 2.0. Dans la foulée, NVIDIA annonçait que ces modèles seraient optimisés pour ses GPU, et en particulier pour le DGX Spark – ce « supercalculateur d’IA personnel » que la firme de Santa Clara décrit comme « le premier ordinateur de bureau conçu pour l’IA agentique ». La convergence de ces deux annonces a immédiatement suscité un engouement rare.
Pourquoi un tel intérêt ? Parce que Gemma 4 n’est pas un énième modèle open source. Google a mis l’accent sur le raisonnement, le codage, l’agentic AI (appel de fonctions) et le multimodal (vision, vidéo, audio). La famille se décline en quatre variantes, dont les caractéristiques précises sont documentées par NVIDIA :
| Modèle | Architecture | Paramètres totaux | Paramètres actifs | Contexte max | Modalités |
|---|---|---|---|---|---|
| Gemma-4-31B | Dense Transformer | 31B | — | 256K tokens | Texte, vision, vidéo, audio |
| Gemma-4-26B-A4B | MoE – 128 experts | 26B | 3,8B | 256K tokens | Texte, vision, vidéo, audio |
| Gemma-4-E4B | Dense Transformer | 7,9B (avec embeddings) | 4,5B effectifs | 128K tokens | Texte, audio, vision, vidéo |
| Gemma-4-E2B | Dense Transformer | 5,1B (avec embeddings) | 2,3B effectifs | 128K tokens | Texte, audio, vision, vidéo |
Source : NVIDIA Developer Blog, « Bringing AI Closer to the Edge and On-Device with Gemma 4 ».
Les modèles E2B et E4B sont conçus pour une inférence ultra-efficace à faible latence à l’edge, fonctionnant complètement hors ligne avec une latence quasi nulle sur de nombreux appareils, y compris les modules Jetson Orin Nano. Les modèles 26B et 31B sont destinés aux workflows de raisonnement haute performance et au développement, avec un support natif de l’appel de fonctions et des capacités multimodales riches (reconnaissance d’objets, transcription vocale, analyse de documents et de vidéos). Google annonce un support multilingue natif de plus de 35 langues, avec un pré-entraînement sur plus de 140 langues.
Le DGX Spark, de son côté, n’est pas un simple PC. Équipé d’une mémoire unifiée (128 Go ou, depuis le 23 octobre 2026, 64 Go) et du superchip GB10 Grace Blackwell, il promet de faire tourner des modèles jusqu’à 200 milliards de paramètres sur un seul nœud. Son prix a évolué au fil des mois, et la donne a changé à l’automne : la version 128 Go, fixée à 4 699 $ au printemps, s’établit désormais au-dessus de 6 000 $ sur le marché, tandis que la nouvelle mouture 64 Go débarque à 4 999 $ (Frandroid, Pause Hardware, Clubic). En France, comptez plutôt 3 200 à 3 800 € TTC selon le SKU pour les configurations 128 Go, avec des variantes OEM comme l’ASUS Ascent GX10 affichée 500 à 1 000 $ moins cher (outilsia.fr). Associé à Gemma 4, il devient le candidat idéal pour ceux qui veulent une IA de pointe sans dépendre du cloud.
Les enjeux sont clairs : souveraineté numérique, latence zéro, possibilité de travailler hors ligne, et contrôle total des données. Alors que les entreprises et les développeurs cherchent à échapper aux API coûteuses et aux risques de fuite, la combinaison Gemma 4 + DGX Spark apparaît comme une solution crédible.
DGX Spark sous le capot : 128 Go unifiés, NVLink-C2C et le chip GB10
Les spécifications officielles du DGX Spark sont désormais bien documentées. Le système embarque une mémoire unifiée LPDDR5X cadencée à 273 GB/s, une bande passante suffisante pour charger des modèles de 31 milliards de paramètres en FP16 (environ 62 Go) tout en conservant de la place pour un contexte long. Le chip GB10 Grace Blackwell intègre un GPU Blackwell miniaturisé (environ 6 144 cœurs CUDA, support FP4) et un CPU Grace à 20 cœurs ARM Neoverse V2, le tout dans un boîtier silencieux de 170 W.
L’interconnect NVLink-C2C permet de relier deux DGX Spark pour l’inférence distribuée et le fine-tuning, via NCCL (source : build.nvidia.com/spark/nccl). Cette connectivité ouvre la voie au clustering, que nous aborderons plus loin. En pratique, le lien entre deux Spark s’effectue via un câble QSFP 200 Gb/s, une évolution notable par rapport aux premières annonces qui évoquaient du 100 GbE (qdna.fr).
Côté performance brute, le DGX Spark atteint environ 1 PFlops en précision mixte. En pratique, c’est l’équilibre entre mémoire, bande passante et consommation qui fait sa force. L’architecture Blackwell apporte un atout majeur : le format de données NVFP4, qui permet de compresser les modèles jusqu’à 70 % sans perte d’intelligence (blog NVIDIA).
La bascule d’octobre 2026 : 64 Go, 128 Go et une nouvelle grille tarifaire
Le fait marquant de cet automne est commercial. Le 2 octobre 2026, NVIDIA a officialisé un DGX Spark doté de 64 Go de mémoire unifiée, commercialisé à 4 999 dollars à partir du 23 octobre 2026 chez plusieurs constructeurs (blog NVIDIA, Clubic, NeoTeo). Le même jour, la version 128 Go a vu son prix grimper au-delà des 6 000 dollars, conséquence directe de la flambée des cours de la mémoire (LP)DDR5 (Pause Hardware, Hardware & Co, Generation-NT).
Le paradoxe est contre-intuitif : la nouvelle mouture embarque deux fois moins de mémoire mais coûte plus cher que le prix de lancement de l’originale 128 Go en 2025 (4 999 $ contre 3 999 $ à l’époque, selon kod.ru). NVIDIA assume ce positionnement en ciblant explicitement les développeurs qui veulent faire tourner des agents locaux avec la pile logicielle complète, et qui pourront monter en puissance en clusterisant plusieurs nœuds 64 Go à mesure que leurs charges grandissent (blogs.nvidia.com). La firme détaille aussi les tailles de modèles visées sur un ou deux systèmes, avec un test Qwen 3.8 27B affiché jusqu’à 1,7 fois plus rapide dans certaines configurations (NeoTeo).
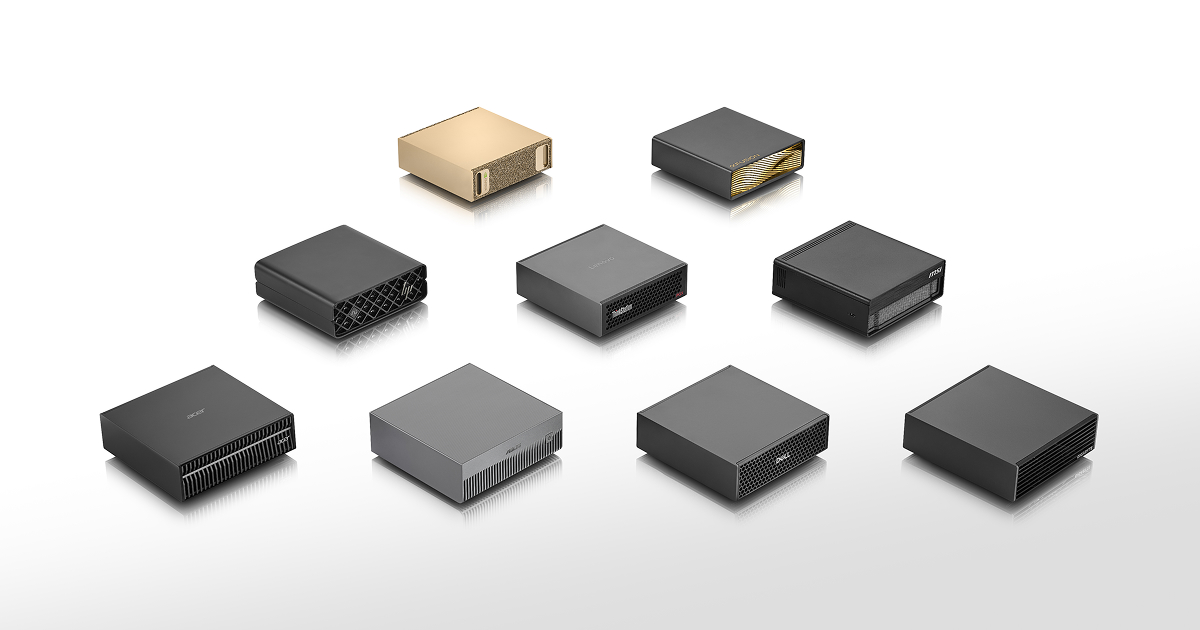
Côté OEM, la concurrence s’organise. ASUS a dévoilé le 5 octobre 2026 son Ascent GX10 64 Go, présenté comme un « supercalculateur d’IA agentique compact » capable de faire tourner des modèles open source de 30 à 35 milliards de paramètres et des agents en local avec 1 PFLOP de calcul (press.asus.com). La plateforme GB10 est identique, mais le prix, le stockage, le refroidissement et la disponibilité diffèrent sensiblement (Techgenyz). Acer, de son côté, livre ses mini-PC GB10 depuis le 8 septembre 2026, avec 128 Go de mémoire unifiée et un positionnement 500 à 1 000 $ sous le prix NVIDIA officiel.
Mises à jour logicielles de l’été et de l’automne 2026
Le 14 juillet 2026, NVIDIA a commencé à déployer les mises à jour logicielles du DGX Spark dans le cadre de la « July 2026 Release ». Les forums développeurs NVIDIA indiquent notamment une amélioration de la gestion de la mémoire (« Improved Memory Management »). Les systèmes partenaires basés sur le GB10 Grace Blackwell peuvent recevoir ces mises à jour avec un léger décalage. Cette mise à jour est cruciale pour les utilisateurs qui poussent les contextes longs et le fine-tuning : une meilleure gestion mémoire se traduit par moins de swaps et des sessions plus stables.
Parallèlement, NVIDIA a publié le CUDA Toolkit 13.4 en preview pour Windows on Arm (juillet 2026), ouvrant la voie aux futurs PC RTX Spark. Les développeurs peuvent dès maintenant compiler des applications natives Arm64, et SEGA l’a déjà adopté (techtimes.com, igorslab.de). Les premiers PC portables RTX Spark d’ASUS et MSI sont attendus dès l’automne 2026, avant Acer et Gigabyte qui visent début 2027 (clubic.com, lesnumeriques.com).
La rentrée a accéléré la cadence. Le 5 septembre 2026, le firmware du DGX Spark a intégré un certificat de démarrage Windows UEFI (Windows Boot Certificate), signe que la plateforme se prépare à accueillir des charges de travail Windows aux côtés de DGX OS (StorageReview). Le 3 septembre 2026, NVIDIA a annoncé une simplification du support de l’IA locale pour tous ses GPU embarquant 24 Go de VRAM ou plus, avec des optimisations simultanées pour vLLM et llama.cpp (wccftech.com). Enfin, la collaboration avec llama.cpp a porté ses fruits : NVIDIA annonce un gain de performance moyen de 35 % sur les modèles open-source exécutés sur DGX Spark, ainsi qu’un chargement accéléré des modèles (blog NVIDIA).
Le point d’orgue est arrivé en septembre : NVIDIA a dévoilé NVIDIA PAIR (Personal AI Router), un outil gratuit et open source qui découvre les appareils compatibles sur votre réseau domestique et route l’inférence entre eux. DGX Spark et RTX Spark fournissent le matériel ; PAIR orchestre. C’est, selon plusieurs observateurs, la manière dont NVIDIA prépare la vague de « Spark PCs » attendue en octobre 2026 (computeleap.com, LinkedIn – Anthony Tracey).
Enfin, le 30 octobre 2026, NVIDIA a détaillé un workflow en ligne de commande pour exécuter Nemotron-3.5 Lightning sur le DGX Spark 64 Go, données de benchmark et résultats de décodage spéculatif à l’appui (blockchain.news). Une démonstration concrète que la nouvelle mouture 64 Go n’est pas un simple déclassement, mais une cible assumée pour les modèles optimisés par NVIDIA.
Installer Gemma 4 sur le Spark : du téléchargement à la première inférence en 30 minutes
L’installation de Gemma 4 sur le DGX Spark est facilitée par l’écosystème NVIDIA. Le blog officiel confirme que les modèles sont supportés dès le premier jour par des partenaires comme Ollama, llama.cpp et Unsloth. L’application OpenClaw permet de créer des assistants IA toujours actifs sur RTX PCs et DGX Spark.
Pour les développeurs, la procédure est simple. Avec Unsloth, quelques commandes suffisent :
pip install unsloth
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained("google/gemma-4-26b-it")
Sur le DGX Spark, le chargement du modèle 26B en 4 bits (via bitsandbytes) prend environ 2 à 3 minutes. La première inférence est quasi instantanée – moins d’une seconde pour une question simple. En comparaison, sur un PC classique avec 32 Go de RAM et une RTX 4090, le même modèle nécessite une quantification plus agressive et peut saturer la mémoire.
Le choix de la stack logicielle fait une différence significative. Le benchmark d’AI Muninn montre que vLLM en NVFP4 atteint 52 tok/s sur Gemma 4 26B-A4B, contre 40 tok/s avec Ollama en Q4_K_M – soit 30 % d’écart sur la même machine (AI Muninn, avril 2026). La cause : les kernels Marlin, les CUDA graphs et un piège de répartition CPU/GPU dans Ollama. Pour une production, vLLM est donc recommandé ; pour une prise en main rapide, Ollama reste le plus simple. La documentation officielle vLLM consacre d’ailleurs un guide dédié à l’architecture et à la configuration sur DGX Spark (vllm.ai).
Les outils NVIDIA comme NeMo et TensorRT-LLM sont également compatibles, mais leur installation requiert quelques étapes supplémentaires. Pour une première prise en main, Hugging Face Transformers + bitsandbytes reste le chemin le plus simple.
Le premier boot en pratique : dix réglages qui changent tout
Un retour d’expérience détaillé publié par OutilsIA rappelle que le DGX Spark est une machine headless : pas de HDMI/DisplayPort utilisable au quotidien. Il faut la brancher au réseau, la découvrir via mDNS ou son routeur, puis tout piloter en SSH. Comptez environ 3 heures pour la séquence complète de premier démarrage : vérification de CUDA 13.0 (36 °C / 3 W au repos = bon signe), préparation d’une clé USB de recovery en cas de kernel panic, découverte de DGX OS (Ubuntu Server 24.04 ARM), configuration de Docker ARM — la vraie friction —, premier modèle Ollama ARM, puis premier agent autonome local. Le guide insiste sur un point que les reviews anglo-saxonnes passent sous silence : les frictions ARM sont réelles, notamment pour les images Docker non natives.
Benchmarks sous tension : Gemma 4 face à DeepSeek V4 Flash, MiMo-V2.6 et les nouveaux venus
Grâce au benchmark réalisé par AI Muninn (ai-muninn.com), nous disposons de chiffres précis pour Gemma 4 sur DGX Spark. Les tests mesurent la vitesse d’inférence et la consommation mémoire pour chaque variante, en différentes quantifications.
| Variante | Quantification | Tokens/s (prompt court) | Mémoire utilisée | Contexte max testé |
|---|---|---|---|---|
| E2B | FP16 | ~120 tok/s | ~5 Go | 256k tokens |
| E4B | FP16 | ~95 tok/s | ~8 Go | 256k tokens |
| E4B | NVFP4 | ~50 tok/s | ~4 Go | 256k tokens |
| 26B | NVFP4 (vLLM) | ~52 tok/s | ~18 Go | 256k tokens |
| 26B | INT4 (Ollama) | ~40 tok/s | ~18 Go | 256k tokens |
| 31B | NVFP4 | ~7 tok/s | ~22 Go | 256k tokens |
Ces chiffres confirment une réalité simple : le DGX Spark excelle sur les modèles de taille intermédiaire (jusqu’à ~35B) et devient nettement plus lent au-delà. C’est précisément pourquoi le cluster à deux nœuds prend tout son sens.
Ce que deux, quatre ou huit Spark changent vraiment
Le cluster est la vraie réponse à la limite mémoire. Selon le guide de recherche approfondie de pyshine.com, un seul Spark plafonne autour de 35B en pratique confortable, tandis qu’un cluster de deux Spark supporte jusqu’à 405 milliards de paramètres. Les chiffres mesurés sur DeepSeek-V4-Flash en FP8 avec vLLM en tensor-parallel (TP=2) sont éloquents :
- Débit single-stream : ~41 tok/s
- Débit agrégé à concurrence 32 : ~350 tok/s
- Prefill : ~1 785 tok/s
- Pool de cache KV partagé : 1 105 096 tokens
À titre de comparaison, un seul Spark sur DeepSeek-V4-Flash en IQ2_XXS (via ds4.c) plafonne à ~14 tok/s en single-stream, avec un prefill de 410 tok/s. Le passage à deux nœuds multiplie donc le single-stream par près de trois et le prefill par plus de quatre. Sur les modèles plus petits, llama.cpp atteint jusqu’à 67 tok/s sur un 35B-A3B sur un seul Spark.
Le 29 septembre 2026, Artificial Analysis a lancé AA-AgentPerf-Local, un benchmark dédié aux performances agentiques locales, testant au lancement quatre modèles open weight sur DGX Spark, Ryzen AI Halo, MacBook Pro (M5 Pro) et RTX 5090. Une initiative qui comble un manque : jusqu’ici, les benchmarks mesuraient des tokens par seconde, pas la capacité réelle d’un agent à enchaîner les appels d’outils.
La concurrence s’intensifie d’ailleurs. Le 14 octobre 2026, AMD a lancé son Ryzen AI Halo 192 Go à 7 299,99 $ chez Micro Center, premier desktop compact capable de charger des modèles open weight de 300 milliards de paramètres. Mais les benchmarks indépendants sont clairs : le DGX Spark garde l’avantage en vitesse (TechTimes). La mémoire ne fait pas tout.
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
Le fine-tuning est l’un des arguments les plus forts du Spark, et l’un des plus mal compris. La mémoire unifiée de 128 Go permet d’envisager des pipelines LoRA et QLoRA sur des modèles de 7 à 30 milliards de paramètres sans recourir au cloud. Les outils qui fonctionnent réellement en octobre 2026 sont NeMo (framework NVIDIA), Unsloth (le plus rapide pour LoRA sur modèles Hugging Face), et LLaMA Factory (interface unifiée multi-méthodes).
En pratique, un QLoRA sur un modèle 26B en 4 bits tient dans la mémoire du Spark, avec un batch size modeste. Le full fine-tune, lui, reste hors de portée sur un seul nœud pour les modèles au-delà de ~8B : il faut alors passer au cluster, où NVLink-C2C et NCCL permettent de distribuer l’entraînement sur deux nœuds. C’est là que le Spark révèle sa vraie nature : moins une station d’inférence qu’une plateforme d’expérimentation pour équipes qui veulent garder leurs données à la maison.
Clusters DGX Spark : deux, quatre, huit nœuds
Le clustering est la frontière qui sépare le gadget du sérieux. Deux Spark reliés en QSFP 200 Gb/s via NVLink-C2C forment l’unité de base : 256 Go de mémoire unifiée, 405B de paramètres supportés, et un pool de cache KV dépassant le million de tokens. Au-delà, quatre et huit nœuds permettent d’envisager des modèles de classe 600B+ et des entraînements distribués plus ambitieux, au prix d’une complexité réseau et logicielle croissante.
Progress Software a d’ailleurs annoncé le 30 juillet 2026 la compatibilité de sa plateforme Chef Enterprise Management avec le DGX Spark, à 189 dollars par an et par système — un signal clair que le cluster Spark sort du labo pour entrer dans la gestion de parc d’entreprise (Progress Software). Pour les équipes qui déploient plusieurs nœuds, l’enjeu n’est plus la performance brute mais la reproductibilité : images, configurations, mises à jour firmware.
Quel stack choisir en octobre 2026 ?
Le paysage logiciel s’est structuré en sept grandes familles : vLLM (production, NVFP4, TP), Ollama (prise en main), llama.cpp (flexibilité GGUF), TensorRT-LLM (performance maximale, courbe d’apprentissage raide), NIM (microservices NVIDIA), LiteLLM (routage multi-modèles) et NVIDIA PAIR (orchestration réseau). Le choix dépend de l’usage : pour un agent local toujours actif, PAIR + Ollama est le chemin le plus court ; pour un service à forte concurrence, vLLM en NVFP4 s’impose ; pour le fine-tuning, Unsloth + NeMo.
La bascule d’octobre 2026 rebat toutefois les cartes. Avec un Spark 64 Go à 4 999 $ et un 128 Go au-delà de 6 000 $, la question n’est plus « un ou deux Spark ? » mais « un gros ou deux petits ? ». La réponse dépend de la charge : pour l’inférence single-stream sur des modèles ≤35B, un seul nœud suffit ; pour les modèles de classe 100B+ ou le fine-tuning distribué, deux nœuds 64 Go deviennent plus pertinents qu’un seul 128 Go, malgré un coût total supérieur. Le DGX Spark n’est plus un produit, c’est une architecture.
Sources
- NVIDIA Developer Blog – Bringing AI Closer to the Edge and On-Device with Gemma 4
- NVIDIA Blog – DGX Spark and Station: Open Source Frontier Models
- NVIDIA Blog – DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI (2 octobre 2026)
- NVIDIA Build – NCCL sur DGX Spark
- AI Muninn – vLLM vs Ollama sur DGX Spark
- AI Muninn – Série de benchmarks DGX Spark
- vLLM – Architecture, Configuration and Local Inference on DGX Spark
- Pyshine – The Best DGX Spark for Local AI in 2026 (1er octobre 2026)
- OutilsIA – DGX Spark / ASUS GX10 : premier boot en IA locale
- QDNA – DeepSeek local sur DGX Station et Spark avec vLLM
- Frandroid – Nvidia lance le DGX Spark en 64 Go (2 octobre 2026)
- Clubic – NVIDIA lance un DGX Spark 64 Go (2 octobre 2026)
- Pause Hardware – Le DGX Spark perd la moitié de sa mémoire (2 octobre 2026)
- NeoTeo – DGX Spark 64 Go : NVIDIA annonce une configuration (3 octobre 2026)
- Generation-NT – Nvidia DGX Spark 64 Go (4 octobre 2026)
- ASUS Press – Ascent GX10 64GB (5 octobre 2026)
- Techgenyz – ASUS Ascent GX10 vs NVIDIA DGX Spark (5 octobre 2026)
- TechTimes – AMD Ryzen AI Halo 192GB vs DGX Spark (14 octobre 2026)
- Blockchain.news – NVIDIA edge AI workflow, Nemotron-3.5 Lightning sur DGX Spark 64 Go (30 octobre 2026)
- StorageReview – Firmware DGX Spark, certificat Windows UEFI (5 septembre 2026)
- WCCFtech – Optimisations IA locale vLLM et llama.cpp (3 septembre 2026)
- Computeleap – NVIDIA PAIR
- Progress Software – Chef Enterprise Management sur DGX Spark (30 juillet 2026)
- Artificial Analysis – AA-AgentPerf-Local (29 septembre 2026)
Article recherché et rédigé automatiquement · Magazine Electrosens