
 NVIDIA DGX Spark · 1 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : le comparatif complet des stacks logicielles à l’automne 2026
Le NVIDIA DGX Spark GB10 promet de faire tourner des LLM de classe 100 à 200 milliards de paramètres sur un bureau silencieux de 170 W. Mais entre LiteLLM, vLLM, Ollama, llama.cpp, Llama Swap, Atlas et TensorRT Edge-LLM, le choix de la stack logicielle est tout aussi crucial que le matériel. Avec les mises à jour de l’été et de l’automne 2026 — la bascule tarifaire du 23 octobre, le DGX Spark 64 Go, Cluster Assistant, NVFP4, DeepSeek V4 Flash 0731, Ant Ling-3.0-Flash, Poolside Laguna S 2.1, Nemotron 3.5 Lightning et l’arrivée de Perplexity Portable Computer — la donne change radicalement. Ce comparatif vous guide à travers les forces, faiblesses et cas d’usage de chaque solution, à partir des tests récents de la communauté et des annonces officielles NVIDIA.
Le DGX Spark GB10 : un mini-supercalculateur taillé pour les LLM locaux
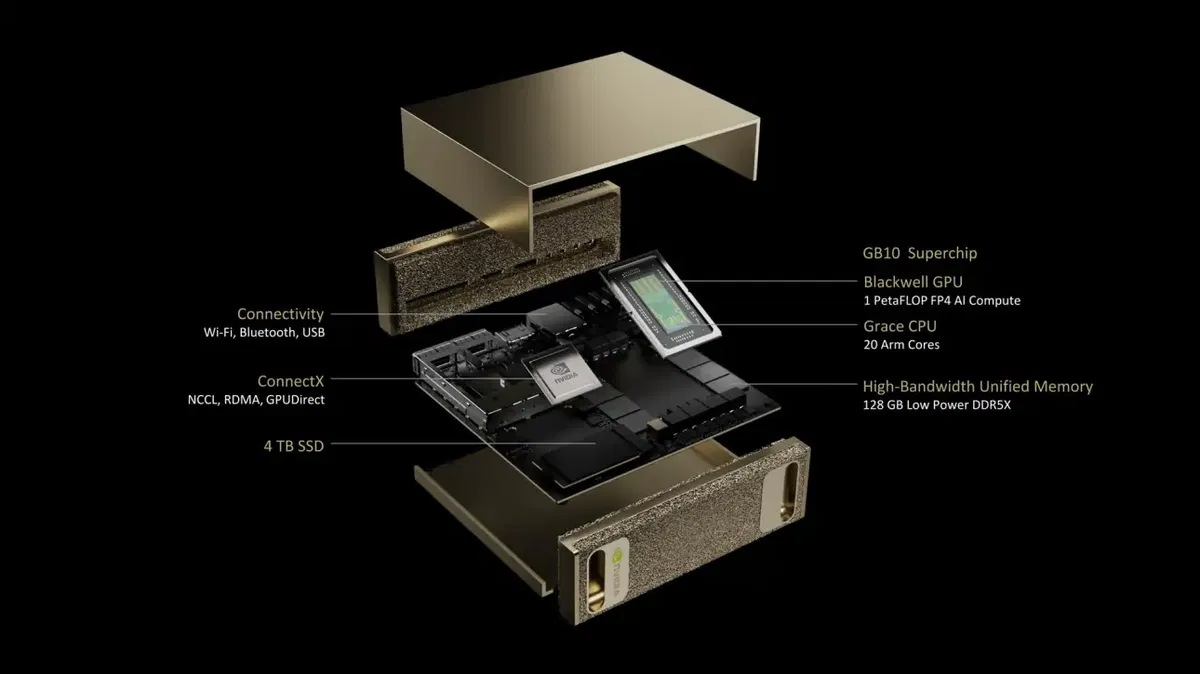
Annoncé lors du GTC 2025 sous le nom de projet DIGITS, expédié depuis fin 2025, le NVIDIA DGX Spark est un mini-PC desktop qui concentre une puissance de calcul inédite dans un format compact. Sa puce GB10 Grace Blackwell associe 20 cœurs ARM Neoverse V2 (10 Cortex-X925 haute performance + 10 Cortex-A725 basse consommation) à un GPU Blackwell d’environ 6144 cœurs CUDA (48 streaming multiprocessors, architecture SM12.1, à l’instar du GB205 qui équipe la RTX 5070), le tout relié à 128 Go de mémoire LPDDR5X unifiée avec une bande passante d’environ 273 Go/s. Le TDP système de 170 W (140 W dissipés en charge par la puce) en fait une machine silencieuse, idéale pour un usage professionnel continu. Avec ses dimensions de 150 × 150 × 50,5 mm et son poids de 1,2 kg, il tient littéralement dans un tiroir (hackernoon.com, frandroid.com).
Positionné comme une alternative au Mac Studio M4 Ultra ou aux configurations dual RTX 3090, le DGX Spark vise les développeurs et chercheurs qui souhaitent exécuter localement des modèles de 70 milliards de paramètres, voire jusqu’à ~200 milliards en quantification 4-bit d’après la communauté. Son système d’exploitation est DGX OS, un Ubuntu Server 24.04 ARM préconfiguré avec le stack NVIDIA AI Enterprise (CUDA 13.0, cuDNN, NCCL, Docker NVIDIA Container Toolkit) — pas de Windows, pas de support officiel pour Claude Code (outilsia.fr).
La bascule d’octobre 2026 : 64 Go, 128 Go et une nouvelle grille tarifaire
C’est le fait marquant de cet automne, et il change la façon dont on dimensionne une stack logicielle. Le 2 octobre 2026, NVIDIA a officialisé une nouvelle déclinaison 64 Go du DGX Spark, commercialisée à partir du 23 octobre 2026 chez plusieurs constructeurs, à 4 999 dollars (blogs.nvidia.com, clubic.com, frandroid.com). Le même jour, la version 128 Go grimpe au-delà des 6 000 dollars sur le marché (pausehardware.com, generation-nt.com). Autrement dit : la version « moitié de mémoire » est désormais plus chère que ne l’était l’originale 128 Go à son lancement (3 999 $ en 2025, puis 4 699 $ en février 2026 après une hausse de 700 $ liée aux contraintes d’approvisionnement mémoire) (hackernoon.com, kod.ru).
Cette bascule a une conséquence logicielle directe : le choix du moteur d’inférence dépend maintenant de la quantité de mémoire, pas seulement du modèle. Sur 64 Go, on vise des modèles 30–35B en open-weight et des agents locaux (1 PFLOP de calcul FP4), comme le positionne ASUS avec son Ascent GX10 64 Go (press.asus.com). Sur 128 Go, on reste sur la classe 100–200B en quantification 4-bit. NVIDIA détaille d’ailleurs les tailles de modèles visées sur un ou deux systèmes, avec un test Qwen 3.8 27B jusqu’à 1,7 fois plus rapide dans certaines configurations (neoteo.com). Et l’astuce marketing de la version 64 Go — dépasser en performance la version 128 Go sur certains workloads — repose précisément sur le clustering : deux Sparks 64 Go valent mieux qu’un seul gros pour l’inférence distribuée (clubic.com).
Trois variantes principales existent, fonctionnellement identiques (même puce GB10) : le DGX Spark officiel NVIDIA, l’ASUS Ascent GX10 (généralement 500 à 1000 $ moins cher, avec une qualité de finition perçue comme supérieure) et les clones MSI EdgeXpert / Acer DGX, dont les premières machines ont été livrées le 8 septembre 2026 avec 128 Go de mémoire unifiée et un positionnement 500 à 1 000 $ sous le prix NVIDIA (outilsia.fr, techgenyz.com).
Capacité réelle : avec 128 Go de mémoire unifiée, le Spark peut adresser des modèles jusqu’à ~200 milliards de paramètres en quantification 4-bit. Un modèle 120B occupe environ 60-70 Go en Q4, laissant de la place pour le contexte et le système (explainx.ai). Les modèles à 100 milliards de paramètres tiennent sur un seul Spark ; les modèles à 1 billion de paramètres nécessitent une DGX Station — dont la version Windows, annoncée le 8 octobre 2026 avec 748 Go de mémoire cohérente et 20 PFLOPs FP4, est attendue au Q4 2026 via six partenaires OEM (tech-insider.org, blogs.nvidia.com).
Un contexte concurrentiel à ne pas négliger : le 14 octobre 2026, AMD a lancé son Ryzen AI Halo 192 Go à 7 299,99 $ chez Micro Center — le premier desktop compact capable de charger des modèles open-weight de 300 milliards de paramètres. Mais les benchmarks indépendants sont nuancés : le DGX Spark reste devant en vitesse sur les charges CUDA-optimisées (techtimes.com, amd.com). En mai 2026, 70 à 80 % des acheteurs de machines à mémoire unifiée préféraient l’AMD Strix Halo pour un usage généraliste, réservant le Spark aux workflows CUDA-only (fine-tuning intensif, vLLM optimisé, recherche ML) (outilsia.fr). La concurrence ne reste pas immobile — mais elle ne détrône pas encore le GB10 sur son terrain.
Mais le matériel n’est qu’une partie de l’équation. Pour transformer cette machine en véritable serveur d’inférence ou en station de fine-tuning, il faut choisir la bonne pile logicielle. Et là, les options sont nombreuses.
Sept solutions logicielles passées au crible
L’article de Dredyson (2026) a testé exhaustivement chaque maillon de la chaîne : application → proxy → swap → moteur d’inférence. Voici le rôle de chaque composant, enrichi des nouveautés de l’automne.
LiteLLM : le proxy API unifié
LiteLLM agit comme un point d’entrée unique compatible avec l’API OpenAI. Il permet de router les requêtes vers différents backends (vLLM, Ollama, llama.cpp) et de gérer les clés API, le rate limiting et le logging. Force : interopérabilité maximale. Faiblesse : overhead réseau et configuration supplémentaire.
Llama Swap : le gestionnaire de modèles
Llama Swap permet de charger et décharger dynamiquement des modèles en mémoire, optimisant l’utilisation des 128 Go unifiés. Idéal pour alterner entre plusieurs LLM sans redémarrer. Force : flexibilité. Faiblesse : nécessite une orchestration fine.
vLLM : le moteur d’inférence haute performance
vLLM est le champion du serving multi-utilisateurs. Il utilise le PagedAttention pour gérer efficacement la mémoire, supporte le tensor parallelism et les quantifications FP4/NVFP4. Force : débit élevé, scaling. Faiblesse : installation plus complexe, dépendances CUDA. NVIDIA recommande des flags spécifiques pour le Spark : --gpu-memory-utilization doit laisser de la marge pour le système et le cache KV, et --max-num-seqs doit rester bas car le Spark est conçu pour du small-batch (source : vllm.ai/blog/2026-06-01-vllm-dgx-spark). En septembre 2026, NVIDIA a poursuivi ses optimisations conjointes avec l’équipe vLLM sur les plateformes RTX et DGX (wccftech.com). C’est le moteur qui tire le meilleur parti du tensor parallelism sur cluster (voir plus bas).
llama.cpp : l’optimiseur CPU/GPU
llama.cpp est conçu pour fonctionner sur CPU avec des quantifications Q4_K_M, mais tire parti du GPU Blackwell via CUDA. Force : légèreté, compatibilité large. Faiblesse : performances inférieures à vLLM sur GPU pur. NVIDIA collabore activement avec l’équipe llama.cpp : les dernières optimisations apportent un gain moyen de 35 % sur les modèles récents exécutés sur DGX Spark, ainsi qu’un chargement des modèles accéléré (blogs.nvidia.com). Les optimisations de septembre 2026 confirment cette dynamique (wccftech.com). C’est aussi la voie empruntée par les projets « from scratch » type ds4.c, qui atteignent ~14 tok/s en single-stream sur DeepSeek-V4-Flash IQ2_XXS et 410 tok/s en prefill sur un seul Spark (août 2026).
Ollama : la simplicité incarnée
Ollama résume l’installation à une commande. Il gère le téléchargement des modèles, le serving et une API compatible OpenAI. Force : prise en main immédiate. Faiblesse : moins de contrôle sur les paramètres d’inférence et le batch processing. C’est le point d’entrée recommandé pour un premier modèle ARM sur le Spark (outilsia.fr).
Atlas : l’inférence Rust pure, légère et prometteuse
Atlas est un moteur d’inférence écrit en Rust, spécialement optimisé pour le DGX Spark. Il promet une faible latence et une empreinte mémoire réduite, sans dépendre de CUDA ou de Python. Force : légèreté extrême, idéal pour les déploiements conteneurisés. Faiblesse : écosystème encore jeune, support de modèles limité (source : atlasinference.io). Les premiers tests communautaires de l’été 2026 montrent des débits impressionnants : 82 tokens/s sur Qwen3-Next-80B, ce qui le place au niveau de vLLM sur les modèles supportés.
TensorRT Edge-LLM : le compilateur avant le runtime
Nouvelle pièce maîtresse de l’automne : le 30 octobre 2026, NVIDIA a détaillé un workflow CLI complet pour faire tourner Nemotron 3.5 Lightning sur un DGX Spark 64 Go via TensorRT Edge-LLM (blockchain.news). Derrière les 127 tok/s annoncés (avec speculative decoding / DSpark) et les 73 tok/s sans DSpark, il faut comprendre ce qu’est cet outil : un compilateur qui convertit un modèle en moteur optimisé pour le matériel cible, avant d’être un runtime. Force : latence minimale, empreinte réduite, exploitation native du NVFP4 et de la mémoire unifiée. Faiblesse : workflow rigide (calibration, versions, dépendances), modèles supportés limités, et benchmarks « vendor » à prendre avec des pincettes. C’est l’option à considérer quand on veut du débit maximal sur un modèle figé, pas quand on explore.
Portable Computer (Perplexity) : la stack clé en main pour agents
Nouveauté d’août 2026 : Perplexity a lancé Portable Computer, une plateforme « local-first » qui transforme le DGX Spark en machine d’agents IA prête à l’emploi, sans cloud ni coût de tokens pour les tâches locales (hothardware.com, heise.de, frandroid.com). Elle exige au minimum 24 Go de VRAM (donc compatible RTX et Spark) et s’appuie sur le modèle PPLX 27B, qui atteint 85,4 % en travail intellectuel agentique à 0 $/token (orcarouter.ai). C’est la première fois qu’un acteur grand public empaquette toute la chaîne (harness, modèle, orchestration) pour le matériel NVIDIA local.
| Solution | Rôle principal | Facilité d’installation | Compatibilité API OpenAI | Support fine-tuning natif |
|---|---|---|---|---|
| LiteLLM | Proxy/routeur | Moyenne | Oui | Non (proxy) |
| Llama Swap | Swap de modèles | Moyenne | Non | Non |
| vLLM | Moteur d’inférence | Difficile | Oui | Non |
| llama.cpp | Moteur CPU/GPU | Facile | Oui | Non |
| Ollama | Serveur complet | Très facile | Oui | Oui (via Modelfile) |
| Atlas | Moteur d’inférence | Facile (Rust) | Oui (prévu) | Non |
| TensorRT Edge-LLM | Compilateur + runtime | Difficile | Non (CLI) | Non |
| Portable Computer | Stack agents clé en main | Très facile | Oui (interne) | Non |
Benchmarks : qui crache les tokens le plus vite ?
Les premiers chiffres de performance pour le DGX Spark proviennent d’un article de dev.to (mrjhnsn, 2026). Ils comparent vLLM et Ollama sur des modèles récents en quantification standard.
| Modèle | vLLM (tok/s) | Ollama (tok/s) |
|---|---|---|
| Llama 4 8B | 45,2 | 38,7 |
| Mistral 7B v0.4 | 52,8 | 45,3 |
| CodeLlama 13B | 28,4 | 24,8 |
| Qwen 3 7B | 49,1 | 42,9 |
vLLM devance Ollama de 15 à 20 % selon les modèles. La différence s’explique par l’optimisation mémoire de vLLM (PagedAttention) et son support natif du batching. Pour un usage mono-utilisateur, Ollama reste très honorable avec ~45 tok/s sur Mistral 7B v0.4.
Mise à jour été-automne 2026 — NVFP4 et modèles 120B+ : NVIDIA a co-développé avec l’équipe vLLM des checkpoints quantifiés NVFP4 pour les modèles récents, tirant parti des cœurs FP4 natifs du Blackwell. Le format NVFP4 permet de compresser les modèles d’IA jusqu’à 70 % sans perte d’intelligence (blogs.nvidia.com). Les benchmarks communautaires montrent des débits de 35 à 80+ tok/s sur des modèles de classe GPT-OSS 120B selon la quantification et la longueur du prompt (explainx.ai). Sur les modèles plus petits, llama.cpp atteint jusqu’à 67 tok/s sur du 35B-A3B (août 2026).
Nouveaux modèles et leurs performances :
- Ant Ling-3.0-Flash 124B-A5B : modèle MoE avec 5B paramètres actifs par token, architecture hybride linéaire (KDA et MLA), fenêtre de contexte 256K tokens (extensible à 1M). Sorti le 23 juillet 2026 par Ant Group, il bat leur précédent modèle 1T sur presque tous les benchmarks. Sur un seul DGX Spark, la communauté estime un débit de 15-20 tok/s (source : forums.developer.nvidia.com). Idéal pour les tâches de raisonnement et de code.
- Poolside Laguna S 2.1 : modèle de 118B paramètres (MoM, 256 experts), open-weight, conçu pour le codage agentique. Sorti le 23 juillet 2026, c’est le premier grand modèle open-weight américain depuis 11 mois. Nécessite un cluster de 2 à 4 DGX Spark pour fonctionner en quantification 4-bit.
- DeepSeek V4 Flash 0731 : c’est lui qui porte les meilleurs chiffres cluster. Sur 2× DGX Spark en TP=2 avec vLLM et FP8, on mesure ~41 tok/s en single-stream, ~350 tok/s agrégés à concurrence 32 et ~1 785 tok/s en prefill (août 2026). Le pool de cache KV partagé atteint 1 105 096 tokens sur deux nœuds.
- Nemotron 3.5 Lightning : le modèle de référence du workflow TensorRT Edge-LLM, avec 73 tok/s sans DSpark et 127 tok/s avec speculative decoding sur un Spark 64 Go (30 octobre 2026).
- Qwen3.6-27B : avec 10 agents concurrents sur un Spark, il tient 136 tokens/s — un chiffre qui illustre la montée en charge agentique.
Le banc d’essai qui manquait : le 29 septembre 2026, Artificial Analysis a lancé AA-AgentPerf-Local, le premier benchmark standardisé de performance agentique locale. Au lancement : 4 modèles open-weight testés sur DGX Spark, Ryzen AI Halo, MacBook Pro (M5 Pro) et RTX 5090. C’est désormais la référence pour comparer les stacks à charge agentique réelle, et non plus seulement en tokens/s bruts.
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
Le fine-tuning est le point où le DGX Spark justifie le plus son prix face à un simple PC IA. Avec 128 Go unifiés, on peut entraîner en LoRA/QLoRA des modèles de 7 à 70B sans déporter les poids hors de la machine. Les pipelines qui fonctionnent à l’automne 2026 s’appuient sur NeMo, Unsloth et LLaMA Factory, avec un choix d’approche selon la taille : LoRA pour itérer vite, QLoRA pour les gros modèles sous contrainte mémoire, full fine-tune réservé aux petits modèles ou aux clusters.
Côté logiciel, aucun des moteurs d’inférence du tableau ci-dessus n’est un outil de fine-tuning natif — Ollama fait exception via son Modelfile, mais cela reste de l’adaptation légère, pas de l’entraînement. La chaîne typique est donc : données → NeMo/Unsloth → checkpoint → quantification NVFP4 → vLLM ou TensorRT Edge-LLM pour le serving. C’est cette continuité, plus que le débit brut, qui distingue le Spark d’une carte graphique consumer : on entraîne et on sert sur la même machine, sans transfert de 70 Go de poids par le bus PCIe.
Clusters DGX Spark : ce que deux, quatre ou huit nœuds changent vraiment
Le clustering est devenu le vrai argument de vente de l’automne 2026, porté par Cluster Assistant et le ConnectX-7 intégré. Les chiffres canoniques :
- 2× DGX Spark : jusqu’à 405 milliards de paramètres supportés, pool de cache KV partagé de 1 105 096 tokens (août 2026).
- 2× DGX Spark + vLLM (TP=2) + DeepSeek-V4-Flash FP8 : ~41 tok/s single-stream, ~350 tok/s agrégés à c=32, ~1 785 tok/s en prefill.
- 4× et 8× DGX Spark : le guide de référence de pyshine.com (1er octobre 2026) détaille les tailles de modèles réellement chargeables à chaque échelle, en tenant compte des 273 Go/s de bande passante par nœud — le facteur limitant en décodage (pyshine.com).
La nuance essentielle : le tensor parallelism sur GB10 souffre de la bande passante mémoire modeste par nœud. Ajouter un nœud double la mémoire disponible et le débit agrégé, mais n’améliore pas linéairement la latence single-stream. D’où l’intérêt du speculative decoding (DSpark) et des formats NVFP4 pour compenser. C’est aussi pourquoi la version 64 Go à deux nœuds peut battre un seul 128 Go sur des charges distribuées — l’astuce tarifaire de NVIDIA n’est pas qu’un argument marketing (clubic.com).
Pour l’exploitation à l’échelle, Progress Chef Enterprise Management est devenu compatible DGX Spark le 30 juillet 2026, à 189 $ par an et par système, avec un protocole agentless/JSON pour le provisionnement des nœuds (progress.com). Un signal clair : le Spark sort du labo et entre dans le parc informatique.
Quel stack choisir en octobre 2026 ?
- Premier contact / prototype : Ollama. Une commande, un modèle, une API. Sur 64 Go, visez du 30–35B ; sur 128 Go, du 70B en Q4.
- Serving multi-utilisateurs ou cluster : vLLM, avec TP=2 dès que le modèle dépasse ~70B. C’est la voie qui exploite le mieux NVFP4 et le cache KV partagé.
- Débit maximal sur un modèle figé : TensorRT Edge-LLM, en acceptant le workflow de compilation et la calibration. Les 127 tok/s de Nemotron 3.5 Lightning sur 64 Go valent l’effort si le modèle ne bouge pas.
- Agents clé en main : Portable Computer (Perplexity) pour un déploiement immédiat, ou les harnesses open source (NemoClaw, OpenClaw) si vous voulez garder la main.
- Contrôle total, empreinte minimale : Atlas (Rust) ou llama.cpp, ce dernier restant le plus polyvalent et le mieux soutenu par NVIDIA (+35 % de gain moyen).
- Orchestration : LiteLLM devant tout ça, avec Llama Swap pour alterner les modèles sans redémarrer.
La vraie question de l’automne 2026 n’est plus « quel moteur est le plus rapide », mais « quelle combinaison tient dans 64 ou 128 Go, à quel prix, et pour quel type de charge ». La bascule tarifaire du 23 octobre a rendu ce calcul plus douloureux qu’il y a un an — mais la maturité logicielle, elle, n’a jamais été aussi bonne.
Sources
- hackernoon.com — How to run your own local LLM, 2026 edition
- blogs.nvidia.com — DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI
- blogs.nvidia.com — DGX Spark and Station for open-source frontier models
- frandroid.com — Nvidia lance le DGX Spark en 64 Go
- frandroid.com — Test du NVIDIA DGX Spark Dell
- clubic.com — NVIDIA lance un DGX Spark 64 Go
- pausehardware.com — Le DGX Spark perd la moitié de sa mémoire
- generation-nt.com — Nvidia DGX Spark 64 Go
- neoteo.com — DGX Spark 64 Go : NVIDIA annonce une configuration
- kod.ru — DGX Spark 64 ГБ
- press.asus.com — ASUS Ascent GX10 64GB
- techgenyz.com — ASUS Ascent GX10 vs NVIDIA DGX Spark
- techtimes.com — AMD Ryzen AI Halo 192GB
- amd.com — Welcome to AMD
- tech-insider.org — NVIDIA DGX Station for Windows
- blockchain.news — NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM
- pyshine.com — The Best DGX Spark for Local AI in 2026
- explainx.ai — NVIDIA DGX Spark local LLM best setup 2026
- outilsia.fr — DGX Spark ASUS GX10 premier boot IA locale 2026
- vllm.ai — vLLM on DGX Spark
- wccftech.com — Optimisations NVIDIA/vLLM septembre 2026
- atlasinference.io — Atlas Inference
- forums.developer.nvidia.com — Ant Ling-3.0-Flash 124B-A5B
- hothardware.com, heise.de, orcarouter.ai — Perplexity Portable Computer
- progress.com — Progress Chef Enterprise Management
 Article recherché et rédigé automatiquement · Magazine Electrosens