
 NVIDIA DGX Spark · 1 November 2026
Progress Chef sur DGX Spark : gestion d’entreprise, clusters GB10 et LLM open source — le point complet à l’automne 2026
Le 30 juillet 2026, Progress Software annonçait la compatibilité de sa plateforme Chef Enterprise Management avec le NVIDIA DGX Spark, à un prix de 189 dollars par an et par système. Pour les entreprises qui commencent à déployer des flottes de ces mini-supercalculateurs de bureau, c’est une nouvelle qui change la donne : fini le bricolage manuel, place à une gestion centralisée, automatisée et conforme. Mais depuis, la donne a encore bougé : le 23 octobre 2026, NVIDIA a discrètement remanié sa gamme avec une mouture 64 Go du DGX Spark, tandis que le modèle 128 Go voyait son prix s’envoler au-delà des 6 000 dollars. Que vaut vraiment l’intégration Chef dans ce paysage mouvant ? Décryptage enrichi des retours d’expérience, des guides de clustering, des nouveaux modèles open source et des benchmarks de l’été et de l’automne 2026.
L’annonce qui change la donne : Progress Chef entre dans l’arène DGX Spark
Le 30 juillet 2026, Progress Software a officialisé le lancement de Progress Chef Enterprise Management for NVIDIA DGX Spark, au tarif de 189 dollars par an et par système. L’information, diffusée via un communiqué de presse et reprise par le site Programmez!, marque une étape clé dans la maturation du petit supercalculateur de Nvidia. Jusqu’ici, le DGX Spark – commercialisé depuis le 15 octobre 2025 – était un objet de fascination pour les développeurs et les chercheurs, mais un casse-tête pour les DSI. Comment gérer une flotte de ces machines, chacune capable de 1 pétaflop en FP4, sans outil centralisé ?
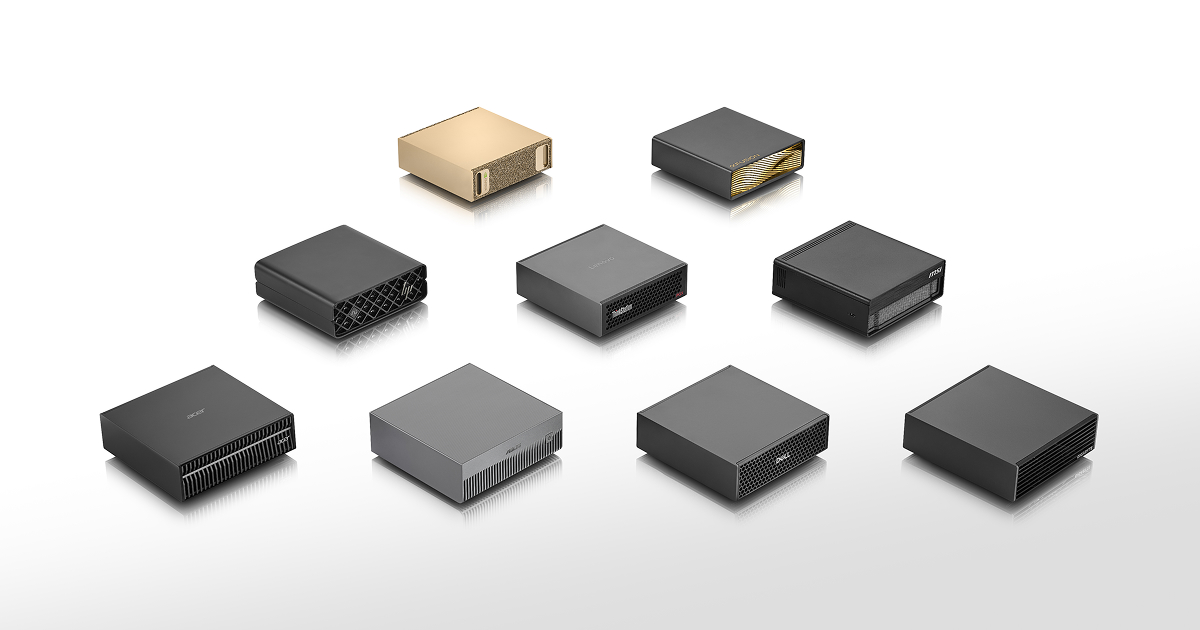
Le DGX Spark, rappelons-le, n’est pas un simple PC. Logé dans un boîtier compact d’environ 15 cm de côté pour 5 cm d’épaisseur, il embarque un SoC Grace (20 cœurs Arm) couplé à un GPU Blackwell, 128 Go de mémoire LPDDR5x unifiée (bande passante 273 Go/s), un stockage NVMe jusqu’à 4 To, et une connectique réseau incluant 10 GbE et une carte Smart NIC ConnectX-7. Sa consommation de 170 W et son format de bureau en font un outil idéal pour le prototypage et l’inférence locale. Mais son succès commercial – rupture de stock dès le lancement – a rapidement posé la question de l’industrialisation.
C’est là que Progress Chef entre en scène. Nvidia avait déjà identifié Progress comme partenaire de « gérabilité d’entreprise » dans un blog développeur publié plus tôt en 2026. L’annonce du 30 juillet concrétise cette collaboration : désormais, les équipes IT peuvent provisionner, surveiller et gérer leurs DGX Spark à l’échelle, avec les mêmes outils qu’elles utilisent pour leurs serveurs Linux traditionnels. Le communiqué précise que l’approche est « policy-driven, zero-trust lifecycle control », alignée sur le framework de gérabilité de Nvidia (Procure, Provision, Monitor, Maintain, Respond, Retire).
La bascule d’octobre 2026 : 64 Go, 128 Go et une nouvelle grille tarifaire
On ne peut plus parler de gestion de flotte sans évoquer le séisme tarifaire de cet automne. Le 2 octobre 2026, NVIDIA a officialisé une nouvelle déclinaison de son mini-supercalculateur : un DGX Spark 64 Go, commercialisé à 4 999 dollars à partir du 23 octobre 2026 chez plusieurs constructeurs. Le même jour, la version 128 Go – celle qui était vendue 3 999 $ au lancement d’octobre 2025, puis ~4 699 $ après la hausse d’avril 2026 – dépasse désormais les 6 000 dollars sur le marché, conséquence directe de l’envolée des cours de la mémoire LPDDR5.
Le paradoxe est savoureux : la nouvelle mouture, deux fois moins dotée en mémoire, est plus chère que ne l’était l’originale à son lancement (4 999 $ contre 3 999 $). Comme le résume Frandroid, la vraie question devient : « faut-il acheter deux petits plutôt qu’un gros ? » Deux Spark 64 Go, mis en cluster via leur réseau 10 GbE et ConnectX-7, offrent 128 Go agrégés et un pool de cache KV partagé – une configuration que la communauté a abondamment documentée cet été.
NVIDIA, dans son blog développeur du 2 octobre, justifie ce positionnement : le Spark 64 Go « fait tourner des agents IA locaux avec la pile logicielle NVIDIA complète, et se met en cluster pour plus de performances à mesure que les charges augmentent ». La cible affichée : les modèles open weight de 30 à 35 milliards de paramètres, avec un test Qwen 3.8 27B annoncé jusqu’à 1,7 fois plus rapide sur deux systèmes que sur un seul.
Pour les DSI, cette fragmentation de gamme complique la gestion : il faut désormais composer avec deux configurations matérielles distinctes (64 et 128 Go), potentiellement des châssis de six fabricants différents (ASUS Ascent GX10, Acer, etc.), et des prix qui varient de 500 à 1 000 dollars sous le tarif NVIDIA selon les partenaires. C’est précisément le genre d’hétérogénéité qu’un outil comme Chef est censé absorber.
Pourquoi le DGX Spark avait besoin d’une gestion d’entreprise : le défi de l’échelle
Imaginez un laboratoire de R&D qui déploie dix DGX Spark pour du fine-tuning de LLM. Chaque machine est configurée manuellement : installation des pilotes CUDA, mise à jour du firmware, déploiement des modèles, réglage des paramètres réseau. Sans outil centralisé, la moindre modification – un correctif de sécurité, une nouvelle version de PyTorch – devient un cauchemar administratif. Les configurations dérivent, les versions divergent, la conformité s’effrite.
Le DGX Spark est conçu pour être utilisé en cluster. Des tests réalisés par PCMag (publiés en 2026) montrent qu’il est possible de relier deux Spark via leur réseau 10 GbE et ConnectX-7 pour former un petit cluster capable de faire tourner des modèles de 70 milliards de paramètres. Mais gérer un tel cluster sans orchestration revient à piloter un avion avec un manche en carton. C’est exactement le vide que vient combler Progress Chef.
La stratégie de Nvidia est claire : faire du DGX Spark non pas un gadget de démonstration, mais une plateforme de production pour l’IA locale. Pour cela, il faut des outils de gestion dignes d’un datacenter. Progress Chef apporte exactement cela : un lifecycle management complet, de la configuration initiale à la mise à jour en passant par la conformité continue.
Progress Chef Enterprise Management : les fonctionnalités clés décortiquées
Le communiqué de Progress liste sept fonctionnalités principales. Décortiquons-les une par une, en imaginant le quotidien d’un administrateur système.
1. Configuration cohérente
Chef permet de définir une configuration « source de vérité » pour l’ensemble des DGX Spark. Plus besoin de se connecter à chaque machine pour vérifier les versions de drivers ou les paramètres réseau. Une recette Chef applique la même configuration partout, en quelques secondes.
2. Visibilité sur la flotte
Un tableau de bord centralisé donne une vue d’ensemble de l’état de chaque nœud : température, charge GPU, espace disque, versions logicielles. Fini les scripts maison qui parsent des logs.
3. Maintenance contrôlée
Les mises à jour peuvent être déployées par cohortes. On peut mettre à jour un sous-ensemble de machines, valider le fonctionnement, puis étendre à toute la flotte. Idéal pour éviter une régression catastrophique.
4. Conformité continue
Chef vérifie en permanence que chaque DGX Spark respecte les politiques de sécurité et de configuration définies. Si un paramètre dévie, une alerte est levée et une correction automatique peut être déclenchée. Pour les environnements soumis à des réglementations comme le RGPD ou HIPAA, c’est un atout majeur.
5. Automatisation gouvernée
Les tâches répétitives (installation de paquets, déploiement de modèles, rotation des logs) sont automatisées via des recettes Chef, mais avec un contrôle d’accès basé sur les rôles. Pas question qu’un stagiaire lance un rm -rf / sur tout le cluster.
6. Réponse aux incidents
En cas de panne ou de dérive, Chef peut déclencher des actions correctives automatiques : redémarrage d’un service, restauration d’une configuration, notification aux équipes.
7. Gestion du cycle de vie
Du provisionnement initial (installation du système d’exploitation, configuration réseau) jusqu’à la mise hors service, Chef accompagne chaque étape de la vie d’un DGX Spark.
Le communiqué résume ces besoins dans un tableau pratique :
| Besoin d’entreprise | Ce que Chef apporte à DGX Spark |
|---|---|
| Configuration cohérente | Maintien d’états approuvés sur toute la flotte |
| Visibilité | Inventaire, santé du système et posture de configuration |
| Maintenance | Modifications et mises à jour par groupes ou cohortes |
| Conformité | Détection de dérives et validation selon les politiques |
| Automatisation | Flux avec rôles, validations et audit |
| Incidents | Diagnostic et collecte de preuves |
| Cycle de vie | Provisionnement, mise à jour, retrait |
Agentless et JSON : le protocole secret de l’intégration Chef-DGX Spark
Techniquement, Progress Chef utilise un modèle d’exécution sans agent (agentless) basé sur SSH. Concrètement, le serveur Chef se connecte à chaque DGX Spark via SSH, exécute les recettes, et récupère les résultats sous forme de JSON standardisé. Cette approche présente plusieurs avantages :
- Pas de logiciel supplémentaire à installer sur le DGX Spark (qui tourne sous DGX OS, une distribution Ubuntu optimisée, comme le confirment les guides Ultralytics et les retours d’utilisateurs).
- Intégration facile avec les workflows d’orchestration existants (Ansible, Terraform), les outils de monitoring (Prometheus, Grafana), les CMDB (ServiceNow) et les solutions de sécurité.
- Sortie JSON qui peut être consommée par n’importe quel système de reporting.
Cette approche agentless est particulièrement adaptée au DGX Spark, dont le système d’exploitation est minimal et optimisé pour l’IA. Pas besoin d’alourdir l’image avec un agent Chef propriétaire. Le communiqué mentionne également que Nvidia a mis en avant Progress Chef dans son blog développeur, ce qui suggère une intégration testée et validée par Nvidia elle-même.
Performances brutes du DGX Spark et impact de Chef sur le provisionnement
Avant de parler de gestion, rappelons de quoi le DGX Spark est capable. Voici un tableau récapitulatif des spécifications clés, compilées à partir des sources officielles et des tests indépendants, avec les mises à jour de l’automne 2026 :

| Caractéristique | Valeur |
|---|---|
| Processeur | SoC Grace (20 cœurs Arm) |
| GPU | Blackwell (architecture Nvidia) |
| Performance IA | Jusqu’à 1 pétaflop en FP4 |
| Mémoire unifiée | 64 Go ou 128 Go LPDDR5x selon la mouture |
| Bande passante mémoire | 273 Go/s |
| Stockage | 1 To ou 4 To NVMe M.2 auto-chiffré |
| Réseau | 1x RJ-45 10 GbE, Smart NIC ConnectX-7, Wi-Fi 7, Bluetooth 5.4 |
| Consommation | 170 W |
| Prix (HT) | 4 999 $ (64 Go, dès le 23/10/2026) ; > 6 000 $ (128 Go, automne 2026) |
En termes de benchmarks, le guide Ultralytics indique que le DGX Spark peut atteindre jusqu’à 1 000 FPS sur YOLO (inférence). Des tests de fine-tuning menés par la communauté (notamment sur Llama 3.1-8B avec PyTorch) montrent qu’il est possible de réaliser un full fine-tuning sur une seule machine, et que la mise en cluster (via 10 GbE) permet de passer à des modèles de 70 milliards de paramètres. Plus récemment, des expériences de clustering à quatre nœuds (décrites dans notre article « Clustering de DGX Spark ») ont montré qu’il est possible d’atteindre des modèles de 700 milliards de paramètres en utilisant NeMo, vLLM et TensorRT-LLM.
Les chiffres mesurés cet été donnent une idée plus précise du terrain de jeu. Sur une seule Spark, un DeepSeek-V4-Flash en quantification IQ2_XXS tourne autour de 14 tok/s en single-stream avec un prefill de 410 tok/s ; en llama.cpp sur un modèle 35B-A3B, on grimpe jusqu’à 67 tok/s. En configuration deux nœuds avec vLLM en tensor parallel (TP=2) et DeepSeek-V4-Flash en FP8, le débit single-stream atteint ~41 tok/s, le prefill ~1 785 tok/s, et le débit agrégé à concurrence 32 ~350 tok/s. Deux Spark peuvent supporter jusqu’à 405 milliards de paramètres et partager un pool de cache KV de 1 105 096 tokens – un chiffre qui change tout pour les charges agentiques à long contexte.
L’impact de Chef sur le provisionnement est difficile à chiffrer précisément (aucune donnée quantitative n’a été fournie par Progress), mais on peut l’estimer : là où un administrateur mettrait 30 minutes à configurer manuellement un DGX Spark (installation des paquets, configuration réseau, déploiement des modèles), une recette Chef peut le faire en quelques minutes, et de manière reproductible sur des dizaines de nœuds. La promesse est une réduction drastique du temps de mise en production.
Ce qui tourne vraiment sur GB10 à l’automne 2026 : le contexte logiciel de Chef
Gérer une flotte, c’est aussi gérer ce qu’on y fait tourner. Et le paysage des LLM open source sur GB10 a beaucoup changé depuis l’annonce de juillet.
Côté inférence edge, NVIDIA a publié le 30 octobre 2026 un workflow CLI complet pour faire tourner Nemotron-3.5 Lightning (30B-A3B, NVFP4) sur un DGX Spark 64 Go via TensorRT Edge-LLM 0.11.1 et TensorRT 10.16.1.11, avec CUDA 13 et Python 3.10–3.12 requis. Le premier lancement télécharge environ 21 Go de fichiers de modèle et compile les moteurs, ensuite mis en cache. Les benchmarks officiels (batch 1, 128 tokens de sortie, NVFP4) donnent 73,3 tok/s sans DSpark et 127 tok/s avec le speculative decoding DSpark activé, pour un time-to-first-token quasi inchangé (~201 ms contre ~203 ms). Des chiffres « vendor » à prendre avec les précautions d’usage – notre article dédié en fait l’autopsie complète.
Côté modèles, la vraie rupture de l’automne est la diffusion : Nemotron-Labs-Diffusion et son mode tri-mode bousculent l’autorégression, avec des gains annoncés jusqu’à 5,9× de tokens par passe. Sur le front des agents, les harnesses open source (NemoClaw, OpenClaw, PAIR, Agent Toolkit) se sont multipliés, et le Spark est désormais vendu comme socle d’agents autonomes locaux. Enfin, le 29 septembre 2026, Artificial Analysis a lancé AA-AgentPerf-Local, un benchmark comparant DGX Spark, Ryzen AI Halo, MacBook Pro M5 Pro et RTX 5090 sur quatre modèles open weight – un outil précieux pour arbitrer les choix d’infrastructure.
Pour un administrateur Chef, tout cela signifie une chose : les recettes doivent versionner non seulement les pilotes et le système, mais aussi les runtimes (TensorRT Edge-LLM, vLLM, llama.cpp), les moteurs compilés et les poids de modèles. La gestion du cycle de vie devient gestion du cycle de vie des modèles.
Chef face à la concurrence : Ansible, Base Command, Kubernetes, Slurm
Comment Progress Chef se positionne-t-il face aux alternatives ? Les sources fournies ne contiennent pas de comparaison directe, mais nous pouvons esquisser une analyse basée sur les caractéristiques connues et les retours d’expérience de la communauté.

Ansible (Red Hat) est sans doute le concurrent le plus direct. Comme Chef, il est agentless et utilise SSH. Sa syntaxe YAML est plus simple que le DSL Ruby de Chef. Cependant, Chef apporte une maturité en matière de conformité (avec InSpec) et une intégration plus poussée avec les workflows d’entreprise (CMDB, ticketing). Pour un environnement déjà équipé de Chef Infra, l’intégration est transparente.
Nvidia Base Command Manager est la solution native de Nvidia pour la gestion de clusters DGX. Mais elle est conçue pour les grands datacenters et son coût est élevé. Pour des flottes de DGX Spark en edge computing ou dans des laboratoires, Chef est plus léger et plus flexible.
Kubernetes est l’outil roi pour l’orchestration de conteneurs, mais il ne gère pas la configuration du système d’exploitation sous-jacent. Chef peut déployer Kubernetes sur un DGX Spark, mais ne le remplace pas. Les deux sont complémentaires. D’ailleurs, le guide officiel de clustering NVIDIA recommande d’utiliser Slurm ou Kubernetes pour l’ordonnancement des jobs, tandis que Chef s’occupe de la configuration de base.
Slurm est le standard du HPC pour l’ordonnancement de jobs. Chef ne fait pas d’ordonnancement ; il gère la configuration. Là encore, ils peuvent coexister.
Puppet est l’autre legacy de la gestion de configuration. Chef et Puppet sont souvent comparés ; Chef a l’avantage d’une communauté plus active dans le monde DevOps, mais Puppet a une base installée solide.
Le principal inconvénient de Chef est sa courbe d’apprentissage (DSL Ruby) et sa dépendance à Progress (éditeur propriétaire, même si Chef Infra est open source). Le coût de la licence Enterprise est désormais connu : 189 $/an par système, ce qui reste modeste pour une flotte d’entreprise – à condition de ne pas oublier que le matériel lui-même a vu son ticket d’entrée bondir cet automne.
Clusters DGX Spark : ce que Chef doit orchestrer au-delà du matériel
La vraie valeur de Chef sur Spark se mesure en cluster. Notre article dédié au clustering de DGX Spark détaille l’anatomie d’un cluster à quatre nœuds : câbles, switchs, protocoles (10 GbE + ConnectX-7), partitionnement des poids avec NeMo et vLLM. Ce que Chef apporte à cette équation, c’est la reproductibilité de la topologie : une recette peut configurer le rang de chaque nœud, les variables d’environnement de tensor parallel, les ports du serveur vLLM, et vérifier que chaque nœud expose bien la même version de runtime.
Le guide de recherche de pyshine.com (1er octobre 2026) chiffre précisément ce que un, deux, quatre et huit Spark peuvent faire tourner, avec les débits de décodage à 273 Go/s de bande passante. C’est exactement le genre de matrice qu’un administrateur veut pouvoir appliquer par cohorte : « ces quatre nœuds en TP=4 pour DeepSeek-V4-Flash FP8, ces deux autres en single-node pour du 35B-A3B ». Chef permet de décrire ces profils comme des états désirés, et de détecter toute dérive.
Reste une limite honnête : Chef ne remplace ni Slurm ni Kubernetes pour l’ordonnancement des jobs. Il gère la configuration du cluster, pas son planning. Pour une flotte de production, l’empilement réaliste est donc : Chef pour le provisioning et la conformité, Kubernetes ou Slurm pour l’ordonnancement, vLLM/TensorRT-LLM pour le serving, Prometheus/Grafana pour l’observabilité.
Le mot de la fin : une brique utile dans un écosystème qui se complexifie
Progress Chef Enterprise Management for NVIDIA DGX Spark n’est pas la révolution qu’on pourrait croire : c’est un outil de gestion de configuration mature, adapté à un matériel qui devient une plateforme de production. À 189 $/an par système, il comble un vide réel pour les DSI qui déploient des flottes de Spark et veulent éviter le bricolage.
Mais l’automne 2026 rappelle une évidence : le vrai défi n’est plus seulement de gérer les machines, c’est de suivre un écosystème qui bouge tous les mois – nouvelle mouture 64 Go, prix du 128 Go au-delà des 6 000 $, runtimes edge (TensorRT Edge-LLM 0.11.1), modèles à diffusion, benchmarks indépendants (AA-AgentPerf-Local). Un outil de gestion n’est utile que s’il sait versionner tout cela. C’est là que se jouera la prochaine bataille : non pas l’installation, mais la gouvernance du changement dans l’IA locale.
Sources
- Progress Software, communiqué « Progress Chef Enterprise Management for NVIDIA DGX Spark », 30 juillet 2026 (repris par Programmez!).
- NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI, blogs.nvidia.com, 2 octobre 2026.
- NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM, blockchain.news, 30 octobre 2026.
- Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ?, Frandroid, 2 octobre 2026.
- Le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 dollars, Pause Hardware, 2 octobre 2026.
- Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher et toujours pour l’IA locale, Generation-NT, 4 octobre 2026.
- ASUS Ascent GX10 64GB: Compact Agentic AI Supercomputer, communiqué ASUS, 5 octobre 2026.
- The Best DGX Spark for Local AI in 2026: LLM Speed, Model Sizes, and Clusters, With Sources, pyshine.com, 1er octobre 2026.
- AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed, Tech Times, 14 octobre 2026.
- Artificial Analysis, lancement du benchmark AA-AgentPerf-Local, 29 septembre 2026.
- Articles du magazine : « TensorRT Edge-LLM sur DGX Spark », « LLM open source sur NVIDIA GB10 DGX Spark : ce qui tourne vraiment à l’automne 2026 », « Agents autonomes sur DGX Spark », « DGX Spark en cluster : faire tourner des LLM open source de 700 milliards de paramètres sur le GB10 », « ASUS Ascent GX10 vs NVIDIA DGX Spark ».
Article recherché et rédigé automatiquement · Magazine Electrosens